


はじめに
会場に掲げられたInterspeech 2026の看板の前で
シドニーのオペラハウス
こんにちは、IT本部AI・データ戦略統括部データサイエンス技術開発部MLイノベーショングループの松永裕太です。普段は、DeNAのスタートアップスタジオである BAKERU と協力し、音声コンパニオン向けのカスケード型音声対話システム(音声認識→対話生成→音声合成を順につなぐ構成)を開発しています。専門は音声合成(TTS: Text-to-Speech)で、大学院時代からTTSの研究に取り組んできました。
今回は、DeNAの国際学会派遣制度1を利用して、音声処理分野のトップカンファレンスであるInterspeech 2026に参加してきました。Interspeechは大学院時代に一度参加したことがあり、今回が2回目です。当時は研究の目線で参加しましたが、今回は新規プロダクトのための研究開発に取り組む部署のメンバーとしての目線での参加になりました。
参加の狙いは大きく2つです。1つ目は、音声AI・音声合成・音声対話の最新技術に関する情報収集。2つ目は、音声分野の日本・海外の研究者・技術者とのコネクションづくりです。情報収集では、①音声合成(TTS)・音声対話・音声認識(ASR: Automatic Speech Recognition)の最新技術はどこまで進んでいるか、②いま開発している音声対話システムの改良や、領域を限定せず今後の新規プロダクト開発に活かせる技術はあるか、という2つの問いを持って会場を回りました。
この記事では、「会場で見えた研究動向」「現地での交流」「持ち帰った学び」の3点で、Interspeech 2026の参加について紹介します。先に結論として、4つの領域で見えた変化と、今回の発表で気になった・参考になった技術を挙げておきます。詳しくは「持ち帰った学び」の節にまとめています。
- TTS:ゼロショット合成の自然さは実用水準に達し、関心は品質の向上から安定性と細かな制御へ移りました。
- 音声対話:焦点は「何を話すか」から、終端の先読みや相づちの判断といった「いつ・どう反応するか」へ移りました。
- ASR:音声LLM(以下Speech-LLM)を使う構成が標準となる中、関心は「LLMとその他エンコーダなどの機能分担」と「再学習なしのhallucination抑制」へ移りました。
- 評価:自然さのMOS(Mean Opinion Score:評価者が5段階で採点する主観評価)一本から用途別の適切さやペア比較の評価へ広がり、評価器を学習の報酬に使う流れが定着しつつあります。
- 今回の発表で気になった・参考になった技術としては、音声対話における終端の先読み、音響+韻律の特徴量による終端検出、ストリーミングTTS+スタイル制御、などがありました。
記事が長くなったので、読み方の目安を書いておきます。TTSだけ知りたい方は「会場で見えた研究動向」の冒頭とTTSの節を、評価に興味のある方は同じ冒頭と「評価・データセット・ベンチマーク」の節を読むと流れが分かります。音声対話・ASRを含む各分野の節は「概観→深掘り→短評→所感」の順に書いているので、概観と所感だけを拾い読みしても要点を追えます。
Interspeechとは — 音声研究が集まる国際会議
Interspeechは、ISCA(International Speech Communication Association:国際音声コミュニケーション学会)が毎年開催する、音声に関する研究全般を扱う国際会議です。今回の Interspeech 2026 はシドニーで開催され、27回目になります。
「音声の研究」と聞いてイメージしやすいのは、音声認識(ASR)・音声合成(TTS)・音声対話といった領域だと思います。これらはもちろん中心的なテーマですが、音声処理の工学的な研究に加えて、人間の発話の仕組みの解明や音声の知覚の分析といった、音声そのものを理解するための理学的な研究も数多く発表されます。実際、今回の プログラム には、Speech-LLMやマルチモーダル音声処理のセッションと並んで、太平洋諸島の言語のための音声技術(Pacific Voices - Speech Science and Technology for Languages of the Pacific Ocean)、TTS・ASRシステムの音声学的側面、対話中の話者同士の同調(entrainment)といった、工学的応用研究に限定しない多様なテーマのセッションが並んでいました。
NeurIPSやICMLといったAI系のトップカンファレンスが最新のAIモデルそのものを主に扱うのに対して、Interspeechには音声に特化した研究や、特定の領域に踏み込んだニッチな研究が集まります。音声分野にはICASSPという同規模の国際会議もありますが、こちらは音響・画像・通信まで含む信号処理全般が対象です。Interspeechはより「人間の音声」に軸足を置いた会議で、日本・海外を問わず、音声分野のトップ研究者が一堂に会する場でもあります。
今回の開催概要
Interspeech 2026 は、2026年9月27日(日)から10月1日(木)までの5日間、オーストラリア・シドニーのInternational Convention Centre Sydney(ICC Sydney)で開催されました。テーマは「Diversity & Equity – Speaking Together」。 公式サイトの開催後メッセージ によると、参加者は70か国から2,200人以上と過去最多で、発表論文1,341件、Show & Tell(デモ発表)37件と、Interspeech史上最大のプログラムだったそうです。基調講演は、John H. L. Hansen氏(UT Dallas)、Steven Bird氏(Charles Darwin University)、Jen Hay氏(University of Canterbury)、Junichi Yamagishi氏(National Institute of Informatics)の4件でした。このうちJohn H. L. Hansen氏は、ISCAが毎年授与する最高賞であるISCA Medalの受賞者(ISCA Medalist)です。
ダーリングハーバーに面したICC Sydney
会場内の雰囲気。企業ブースの周りで参加者が歓談していた
回り方:基調講演とポスターを軸に
Interspeechの発表形式は、口頭発表・ポスター発表・デモ発表(Show & Tell)・基調講演の4つが中心で、前日のチュートリアルや併設ワークショップもあります。私は基調講演とポスターを軸に回り、気になる口頭発表があれば聴きに行くスタイルにしました。ポスターは著者と会話しながら議論でき、限られた時間で多くの研究に触れられるからです。
そのため、次章で紹介する研究は、私の関心(音声合成・音声対話)と実際に回れた範囲に基づく、一参加者の視点によるものです。
実際に参加した主なプログラムの例です。
- 9/28(月)基調講演:John H. L. Hansen「Balancing Speech, Language and Hearing Science with Machine Learning Modeling in the Age of AI」
- 9/28(月)口頭セッション:Scaling and Zero-Shot Speech Synthesis
- 9/28(月)ポスターセッション:Long-Form Speech Synthesis、Evaluation of Speech and Audio Analysis
- 9/29(火)口頭セッション:Speech Synthesis Evaluation 1
- 9/29(火)ポスターセッション:Spoken Dialogue Systems、Robust ASR: Uncertainty and Confidence
- 9/30(水)口頭セッション:Speech Synthesis Evaluation 2
- 9/30(水)ポスターセッション:Emotional Speech Synthesis、Streaming Speech Synthesis、Multilingual Speech 2
- 10/1(木)口頭セッション:LLM Based Speech Synthesis、Turn-taking
会場で見えた研究動向
TTS・音声対話・ASRのどの領域にも共通し、生成モデルではflow matching(ノイズからデータへ変換する流れを学習する、拡散モデルに近い生成手法)と離散トークン化、学習ではDPO/GRPO(Direct Preference Optimization / Group Relative Policy Optimization)などによるpreference optimization(人や評価器の好みに合わせて出力を調整する学習)、評価では正確さ・品質の高さだけでなく場面・コンテキストとの整合性を評価する方向が、多く見られました。一方で、いつ話し始めるか・相づちをどう打つか・聞き手がどう感じるかといった、音声ならではの「会話のふるまい」や「知覚」に踏み込んだ研究も多く、工学系のセッションにも人間の会話を観察する分析的な観点が持たれている印象でした。
参考までに、採択論文のタイトルによく出てくる語句を集計しました2。
Interspeech 2026採択論文タイトルの頻出語句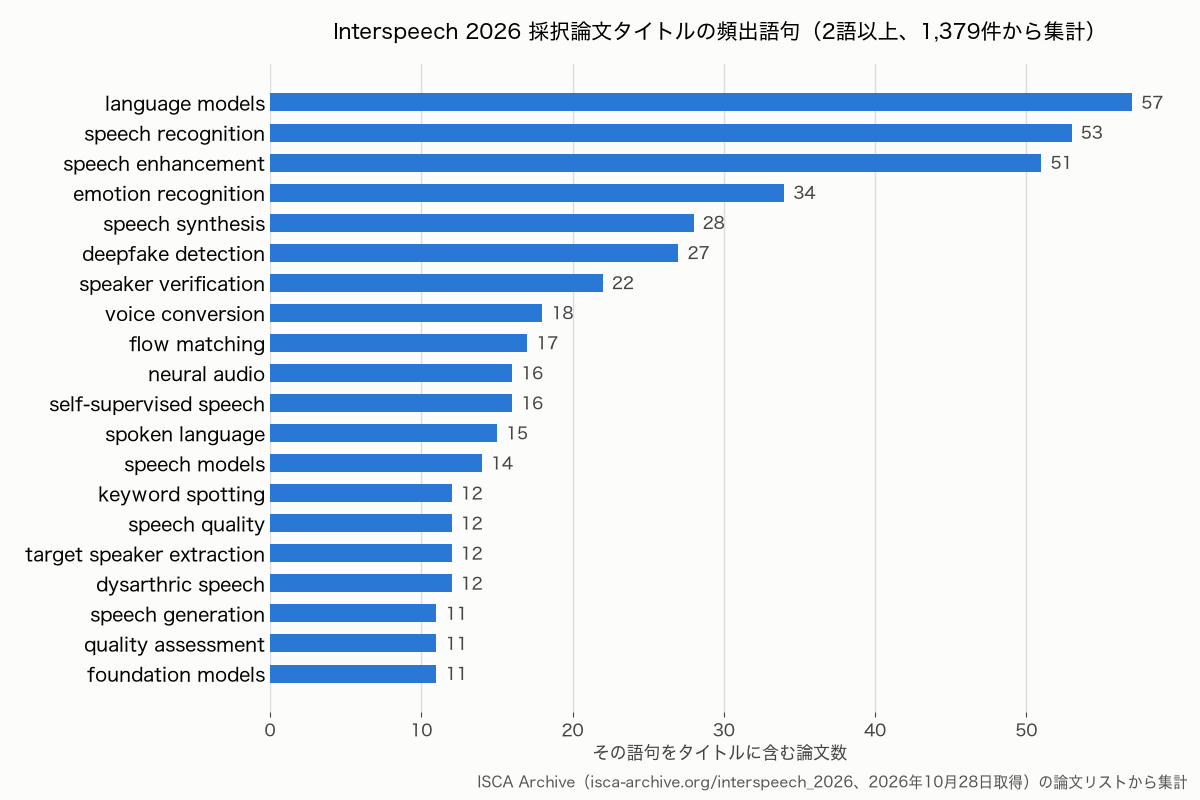
ポスター会場。人気のポスターには順番待ちの列ができていた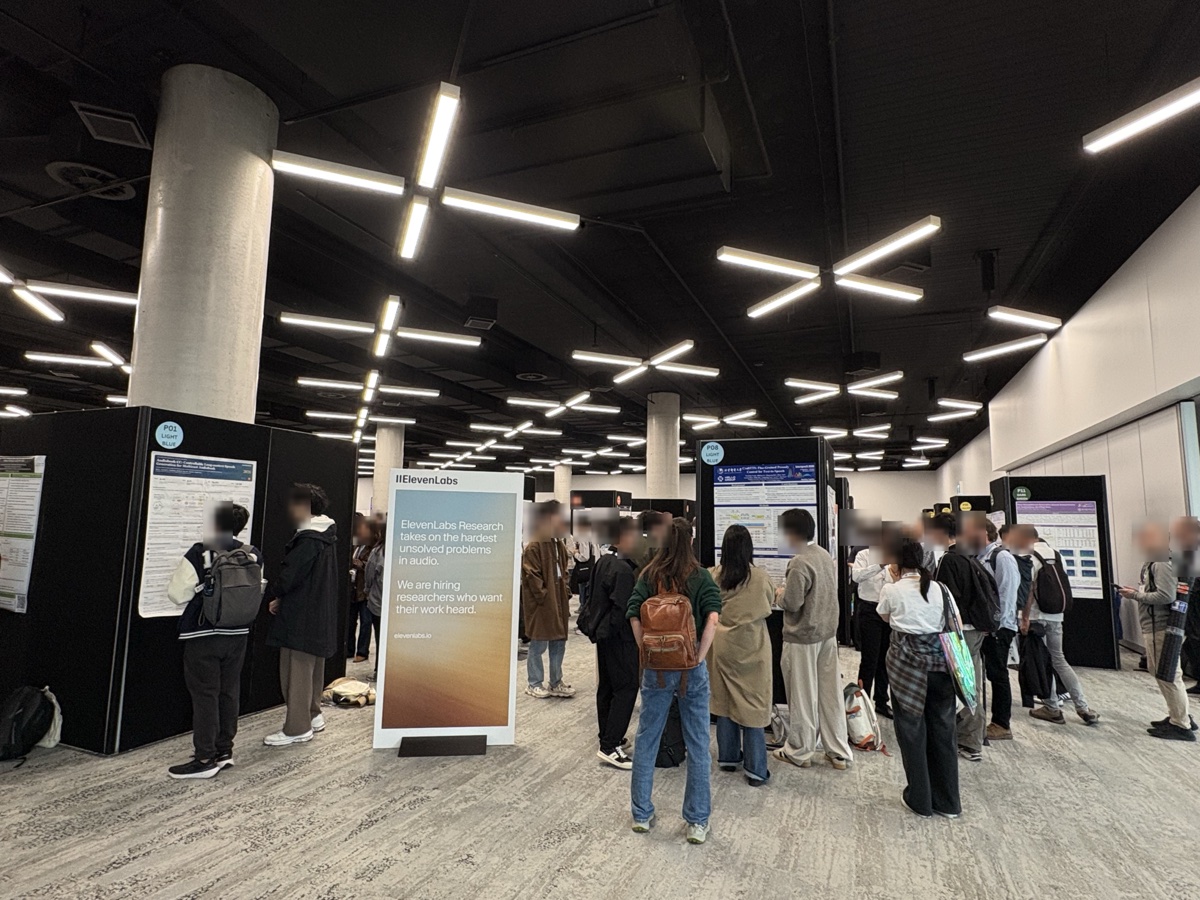
基調講演:最悪の通信環境でも通じる音声システムを目指して
基調講演は4件ありました。ここではとくに、ISCA MedalistのJohn H. L. Hansen氏(UT Dallas)の講演を紹介します。
John H. L. Hansen氏「Balancing Speech, Language and Hearing Science with Machine Learning Modeling in the Age of AI」
講演の主題は、どんな悪環境でも人間とコンピューターが円滑にコミュニケーションできる音声システム、とくに音声認識や話者分離(ダイアライゼーション)を、音声科学・言語科学・聴覚科学の知見と機械学習モデリングのバランスを取りながらどう作るか、というものでした。
具体例として紹介されたのが、NASAと共同で進めてきたFearless Stepsプロジェクトです。NASAの通信で蓄積された約19,000時間の無線通信データを、通信ノイズ、テープの劣化、同時発話、訛りといった「最悪の条件」から復元し、頑健な音声認識の研究開発に使えるデータとして構築した取り組みです。
所感
音声認識の研究が「クリーンな音声で精度を競う」段階を過ぎ、リアルな悪条件を正面から扱っていることを示した講演でした。音声コンパニオン開発も、静かな部屋だけで使われるものは想定していません。雑音・同時発話・訛りへの頑健性は、後述するASRの節のhallucinationの抑制や多話者認識とあわせて、設計の前提に置くべきだと感じました。
TTS:高速化や安定性向上、詳細な制御
概観
音声合成(TTS)はここ数年で、数秒の参照音声からその人の声で任意の文章を読み上げる「ゼロショットTTS」が実用レベルに達しました。手法としては、音声を離散トークン列にしてLLMのように逐次生成する自己回帰(AR)型と、flow matchingや拡散モデルで音声特徴をまとめて生成する非自己回帰(NAR)型の2系統が主流です。自然さや話者性の再現はすでに高い水準にあり、研究の関心は次の3点に移ってきています。
- 安定性:読み飛ばしや同じ言葉の繰り返しといった「hallucination」、長文での声の一貫性低下をどう抑えるか。
- 表現と制御:感情・韻律・話し方を、文単位ではなく単語単位や時間変化として細かく制御できるか。
- 効率:ストリーミングや少ステップ生成による低遅延化・軽量化と、制御性・忠実性をどう両立するか。
Interspeech 2026でTTSのセッションを回って感じたキーワードは、「flow matching」「preference optimization・強化学習」「細かなスタイル制御」の3つでした。flow matchingを「速く、崩壊しにくく」する研究(1ステップ生成、対照学習など)、制御の粒度を文単位から単語・時間方向へ細かくする研究、そしてLLM分野で定番となったDPO/GRPOを学習時・推論時・編集のそれぞれで使う研究が、それぞれ複数ありました。論点ごとの整理を表1に示します。個々の論文は巻末の付録にまとめています。
表1:TTS研究の論点と、Interspeech 2026で見られたアプローチ
| 論点 | これまでの主な課題 | 今回見られたアプローチ | 例 |
|---|---|---|---|
| 生成方式・効率 | flow matchingの反復回数、AR生成の遅さ | MeanFlowによる1ステップ生成、離散flow matching、ブロック型離散拡散でARとNARを併用 | One-Step Token-to-Waveform 、 DLLM-TTS |
| 安定性 | 読み飛ばし・反復、長文での話者の変化 | 失敗軌道との対照学習、信頼度に応じたブロック再分割、長文向けの推論 | RobustSpeechFlow 、 MagpieTTS-LF |
| 表現・制御 | 感情ラベルが文単位 | 単語単位・時間変化の感情強度、参照音声+テキストプロンプト、聞き手ごとの知覚への適応 | CraftTTS 、 Beyond One-Size-Fits-All |
| 学習・適応の手段 | 損失関数の設計が中心 | DPO/GRPOによるpreference optimizationを学習時・推論時・編集に適用 | FlowTTS-GRPO 、 VoiceTTA |
| 低遅延・ストリーミング | 文が揃ってから生成 | テキスト到着中の読み上げ開始、韻律境界での一時停止と再開 | FlashTTS 、 Prosodic Boundary-Aware Streaming |
| 対話・応用 | 単発の読み上げ | 自然言語の依頼から発話内容ごと生成、吹き替えのタイミング制約、音声ドラマ制作 | Bagpiper-TTS 、 AuDirector |
深掘り①:DLLM-TTS — ブロック単位でARとNARを統合する
DLLM-TTS: Block Discrete Diffusion Language Model for Text-to-Speech Synthesis
課題:AR型のTTSは音声トークンを1つずつ順に生成するため、過去との整合性は取りやすい一方で生成が遅く、長くなるほど誤りが積み重なります。逆にNAR型はまとめて生成できて速いものの、長い系列の一貫性では不利になりがちです。
提案:音声トークン列を短いブロックに分け、ブロック間は自己回帰的に、ブロック内は非自己回帰的に生成するハイブリッド構成です。各ブロックは全トークンをマスクした状態から始め、予測確率の高い位置から順にトークンを確定し、残りを繰り返し埋めていきます。ブロックが埋まったら、その内容を条件にして次のブロックへ進みます。テキスト分野で注目される拡散言語モデルの考え方を、離散音声トークンのTTSに持ち込んだ形です。
結果・限界:比較的小さなモデルと学習データで、Seed-TTS-eval(英語)において、はるかに大規模なデータで学習された既存システムと同等の読み間違いの少なさと、オープンソースの中で最高水準の話者類似度・主観品質を示しています。ここでいう読み間違いは、合成音声を音声認識にかけ、単語誤り率(WER)・文字誤り率(CER)で測ります。推論速度は、ブロック内のステップ数を減らした設定で実時間より十分に速くなります。ただしステップ数を減らすと読み間違いが増えるため、速度と品質はステップ数で調整する関係にあります。加えて、ブロック長といった推論時の設定が品質に影響するため、実運用ではここがチューニング項目になりそうです。
位置付け:AR型の「文脈への忠実さ」とNAR型の「速さ」をバランスする流れの1つで、flow matching系の少ステップ化とは別の道から、同じ「速く、崩壊しにくく」を目指しています。
深掘り②:VoiceTTA — 推論時にモデルを話者へ適応させる
VoiceTTA: Enhancing Zero-Shot Text-to-Speech via Reinforcement Learning-Based Test-Time Adaptation
課題:ゼロショットTTSは、参照音声が方言や特殊な話し方だと、そのスタイルをうまくまねられないことがあります。かといって、対象話者ごとに追加学習するのは現実的ではありません。
提案:TTS本体は固定したまま、入力の先頭に加える4本の学習可能なベクトルだけを、話者ごとに推論時に最適化します。最適化したベクトルは軽量なので、保存しておけば同じ話者への以降の合成で再利用できます。報酬は基本周波数(F0:声の高さ)やエネルギー(声の大きさ)の変動、話者類似度、読み間違いの少なさで、GRPOで更新します。
結果・限界:訛りのある話者・子ども・不明瞭な発話・中国語の漫才や方言といった「珍しい参照音声」の平均で、ベースのF5-TTSと比べて話者類似度とスタイル類似度の主観評価が明確に向上し、読み間違いも悪化していません。その反面、適応には話者ごとにGRPOの反復を回し、各反復で複数の候補を合成して報酬を計算するため、初回の適応では合成と評価の回数がかなり増えます。論文は所要時間そのものは報告していません。新しい話者を扱うたびに発生する適応コストと音質改善のバランスが、実運用上の論点になります。
位置付け:同じGRPOでも、FlowTTS-GRPOが追加学習時にLoRA(Low-Rank Adaptation:少数の追加パラメーターだけを学習する軽量な微調整手法)で本体を更新するのに対し、こちらは推論時に適応します。今回、preference optimizationは学習時(Emo-BPO、FlowTTS-GRPO)・推論時(VoiceTTA)・編集(Edit Content, Preserve Acoustics)のそれぞれで使われていて、その「推論時」の代表例です。
短評
CraftTTS は、「この単語を強く」「この部分をゆっくり」と単語単位で話し方を指示できるTTSです。文単位の感情ラベルでは表現できなかった細かな演出が、テキスト上の指示だけで付けられます。指示は、入力テキスト中の単語や句をstrong / weak(強弱)とfast / slow(速さ)の4種類のタグで囲む形で与えます。CosyVoice 2をベースに、LLMで自動付与したタグ付きデータから選好ペアを作り、SFT(Supervised Fine-Tuning:正解データを使った教師あり微調整)、DPO、GRPOの3段階で学習したところ、主観評価で韻律の自然さと速さ指示の一致度が明確に改善しました。ただし読み間違いと話者類似度はベースラインよりわずかに下がっています( デモページ )。
FlashTTS は、テキストが届く途中から読み上げを始めるストリーミングTTSで、初回音声出力までの遅延を大幅に短縮したと報告しています。対話システムではLLMの出力をトークン単位で受け取れるので、この種の手法は体感遅延に直接効きます。品質面では、同規模のストリーミングTTSであるCosyVoice2と比べて、多言語の評価セットで読み間違いが明確に減り、話者類似度はわずかに低いものの、主観評価ではベースラインを上回っています。Seed-TTSのような非ストリーミングの大規模モデルには話者類似度で及ばないため、遅延と引き換えに声の再現性を少し譲る設計といえます( デモページ 、 コード )。
Beyond One-Size-Fits-All は、同じ音声でも感情の受け取り方は人や文化で違う、という点に踏み込んだ研究です。聞き手本人に候補音声を評価してもらい、感情を指定する「覚醒度・快不快」の値を繰り返し調整することで、TTS本体を再学習せずに個人に合わせます。日本・中国・インドネシアの参加者で効果を示しており、「モデルの表現力」ではなく「聞き手の知覚」を最適化対象にする発想が新鮮でした( デモページ )。
所感
flow matchingの少ステップ化や離散化、ARとNARのハイブリッドなど、「速さ」と「崩壊しにくさ」を両立する工夫はかなり出揃ってきた印象です。一方で、読み間違い・話者の変化・長文での崩れは、複数の論文がそれぞれ別の角度から対処している段階で、決定打はまだありません。制御については、単語単位・時間変化の感情制御が当たり前の要求になりつつあり、preference optimizationはそれを学習させる現実的な手段として定着しそうです。
音声対話:「何を話すか」から「いつ話すか」へ
概観
音声対話システムの構成は、音声認識(ASR)→対話LLM→TTSを順につなぐカスケード型から、音声を直接入出力するSpeech-LLM、さらに聞きながら同時に話せるfull-duplexモデルへと広がってきました。構成は違っても、研究の関心は「何を話すか」から「いつ、どう話すか」へ移っています。
1つの発話を自然に合成することと、会話の中で適切に発話することは別の問題です。後者には、相手の話し終わり(以下、終端)の検出、相づちや割り込みのタイミング、応答までの遅延、そして会話の文脈にきちんと従うことが含まれます。このうち、誰がいつ話すかの調整は「ターンテイキング(発話の交代)」と呼ばれます。今回の発表も、この「会話のふるまい」に関するものが多くを占めていました。具体的には、終端を先読みして応答生成を先に始める研究、相づちを打つべき場面と応答を生成すべき場面を区別する研究、複数人会話で自分に向けられた発話かを判断する研究、full-duplexモデルの内容の一貫性を高める研究などです。論点ごとの整理を表2に示します。個々の論文は巻末の付録にまとめています。
表2:音声対話研究の観点と、Interspeech 2026で見られた取り組み
| 観点 | 課題 | 今回見られた取り組み | 例 |
|---|---|---|---|
| システム構成 | カスケード型の遅延、full-duplex型の内容の一貫性 | ターン単位でテキストを先に生成、ASR/TTSの基盤共有 | TurnGuide 、 UniVoice |
| 応答の速さ | 終端を待ってから生成を始める | 終端の先読みと投機実行(speculative execution)、ストリーミングのトークン化 | Endpoint Anticipation 、 TASTE-Streaming |
| 終端検出 | どの特徴量を使うべきか | 音響+韻律が最良、テキスト追加は早すぎる検出を増やす | Less can be More |
| 相づち | タイミングと、相づちで済ませてよいか | 機能別に予測経路を分ける、応答すべき場面の検出 | DP-BCT 、 Considerate Listener |
| 発言の要否(複数人) | 名前が出ても自分宛てとは限らない | 役割・文脈からの判定、推論理由の蒸留 | Adaptive Turn-Taking 、 Speak or Stay Silent |
| 文脈への忠実性 | 認識しているのに応答に反映しない | 文脈あり/なしの出力を対比するデコーディング | From Awareness to Adherence |
| 評価 | 回答の正しさのみを見る | 音声根拠への忠実性、能動的な介入の適切さ | Investigating Faithfulness 、 ProVoice-Bench |
深掘り①:Endpoint Anticipation — 話し終わる前に応答を作り始める
Endpoint Anticipation for Low-Latency Spoken Dialogue
課題:音声対話では、ユーザーの終端を検出してからLLMとTTSを動かすため、「終端検出の待ち時間+生成時間」がそのまま応答遅延になります。人間同士の会話では、相手が話し終わる前に返答の準備が始まっているのが普通です。
提案:ユーザーとシステムの音声をそれぞれ別のストリーミングTransformerで符号化し、数百ミリ秒から数秒先までの各予測窓の中でユーザー発話が終わる確率を推定します。確率が十分高くなった時点で、実際の終端を待たずにLLM・TTSの応答生成を投機的に開始します。
結果・限界:Kyutaiが公開している音声対話システムUnmute(音声認識→LLM→TTSのカスケード構成で、割り込みにも対応)に統合したところ、平均応答遅延が大幅に短縮されました。逆に、予測が外れると先行して生成した計算は捨てられ、その割合(Expected Redundant Computation: ERC)は無視できない大きさでした。「待ち時間を減らす代わりに、ある程度の無駄な計算を受け入れる」という設計上のトレードオフが、定量的に示されています。
位置付け:終端の「検出」を「先読み」に変える研究で、論文はUnmuteのようなカスケード型のパイプラインを対象にしています。私たちのシステムと同じカスケード構成で効果が示されているため、構成を大きく変えずに体感の遅延を縮められる可能性がある、もっとも直接的に参考になる研究でした。
深掘り②:Less can be More — 終端検出に本当に必要な特徴は何か
Less can be More: What Aspects of Speech Drive End-of-Turn Detection
課題:ユーザーの終端を検出するモデルには、音響特徴・韻律特徴・途中までのASRテキストなど、さまざまな入力が使えます。「内容まで読ませれば精度が上がる」と考えがちですが、何がどれだけ効くかは整理されていませんでした。
提案:モデル容量と学習条件を揃えたうえで、音響・韻律・テキストのすべての組み合わせを、ストリーミング終端検出の精度と遅延の両面で比較しました。
結果・限界:対象の会話条件では音響+韻律が最もよいバランスで、テキストを加えると早すぎる終端検出がむしろ増えました。ただし、相づちや多人数会話での発言判断にまで一般化できるかは別問題です。
位置付け:「声の調子とリズムに集中した方がよい」という直感に反する結果で、終端検出器を設計するときにすぐ使える知見です。深掘り①のEndpoint Anticipationが「いつ生成を始めるか」を扱うのに対し、こちらは「何を見て終端を判断するか」を扱っており、組み合わせて使えます。
短評
Considerate Listener は、相づちのタイミング予測に、「ここは相づちではなく返答すべき場面ではないか」という判断を組み込んだ研究です。休止の確率で音響特徴を重み付けし、途中までのASR出力をQ-Former(少数の学習可能なクエリで系列を固定長に要約するTransformerモジュール)で集約して融合します。韓国語のカウンセリング会話で、返答を求める休止に相づちを入れてしまう誤りを、音響のみの基準モデルから大幅に削減しました。
DP-BCT は、相づちの機能ごとにタイミング予測の経路を分ける手法です。タイミング予測の精度が明確に向上しており、「相づち」を一括りにしない発想は、キャラクターらしい聞き方を作るうえで参考になりそうです。
TurnGuide は、Zhipu AIのSpeech-LLMであるGLM-4-Voiceをベースにしたfull-duplex対話モデルで、アシスタントの発話を休止に基づくターン単位にまとめ、各ターンでまずテキストを生成してから音声を生成します。英語の電話会話コーパス(Fisher)で意味的一貫性や発話交代・重なりの指標が改善しました。論文が示す遅延はvocoder(音響特徴量から波形を生成するモジュール)の改修を前提にした理論値で、評価も自動指標が中心です。
所感
会話全体を扱う研究は、「終端を当てる」から、「終端を先読みして準備する」「相づちか応答かを判断する」「誰に向けた発話かを判断する」へと、人間の会話のふるまいに一歩ずつ近づいている印象です。一方で、今回確認した研究の多くは応答をテキストで評価していたり(Adaptive Turn-Taking、From Awareness to Adherence)、自動指標が中心だったりと、音声として人がどう感じるかの評価はこれからです。
開発中のカスケード型システムの観点では、終端の先読みによる投機実行(speculative execution)、音響+韻律に絞った終端検出、相づちの機能別タイミングは、構成を変えずに取り込める改良として試してみたい技術です。full-duplexモデルへの移行は、文脈への忠実性や内容の一貫性がどこまで担保できるかを見ながら判断したいと思っています。
音声認識(ASR):LLMに何を任せ、hallucinationをどう抑えるか
概観
音声認識(ASR)は、音声エンコーダとLLMを組み合わせた「Speech-LLM型」が標準的な構成になりつつあります。単一話者・静かな環境での精度競争はひと段落し、研究の関心は次の3点に移ってきています。
- 役割分担:音声とテキストの対応付け(アライメント)、話者分離、固有名詞の検索といった仕事をLLMの外に出し、LLMには言語的な判断だけをさせるか。
- 頑健性:会議や雑談のように複数人が重なって話す音声を「誰が・いつ・何を」まで認識できるかに加え、OpenAIのWhisperに代表される大規模モデルが音声にない内容を流暢に出力してしまう「hallucination」をどう抑えるか。
- 速度と軽量化:非自己回帰デコード、オフラインとストリーミングの統一、超低ビットの量子化やpruning(重みの削除)を、精度を保ったまま実現できるか。
Interspeech 2026で感じたキーワードは、「LLMに何を任せるか」「hallucinationへの推論時介入」「多話者・会話音声の評価」の3つです。hallucination対策は、ラベル付きデータでの再学習を必要としない手法(推論時のデコードや内部表現の操作、テストデータへの軽量な適応)が多く、運用中のモデルにそのまま適用できる点が強調されていました。学習データについても「量より選び方」「書き起こしスタイル(どこまで忠実に書くか)の明示」といったデータ側の設計が精度と評価の信頼性に直結する、という報告が目立ちました。論点ごとの整理を表3に示します。個々の論文は巻末の付録にまとめています。
表3:ASR研究の論点と、Interspeech 2026で見られたアプローチ
| 論点 | これまでの主な課題 | 今回見られたアプローチ | 例 |
|---|---|---|---|
| Speech-LLM型の設計 | LLMにアライメントまで学習させるため計算コストが大きく、再学習で元の能力を失う | アライメントはASR側に残しLLMは結合器に徹する。LLMを凍結し、音声エンコーダ側を話者分離で条件付ける | LLM-as-Joiner 、 Dixtral |
| 希少語・固有名詞 | 候補語リストをプロンプトに入れると、リストが大きいほど性能が落ちる | 音声に含まれていそうな語を先に絞り込んでからLLMに渡す | COALA |
| hallucinationの抑制 | 無音・雑音や長文で、音声にない文章・反復・脱落が出る | 内部表現からhallucinationを検出し推論時に打ち消す、壊した入力との対照デコーディング、テスト時適応(推論前にテストデータで軽く更新) | Whisper Hallucination Steering 、 Whisper-CD |
| 多話者・会話音声 | Speech-LLM型は単一話者では強いが多話者では脆い。合成データの作り方が不明 | 合成会話データの系統的分析、重なりと意味を考慮した評価指標 | Mind the Gap 、 Who Spoke What When |
| 速度・軽量化 | 自己回帰デコードの遅さ、オフラインとストリーミングの別モデル運用、低ビット量子化での崩壊 | 拡散モデル型の並列デコード、両モードの一致を促す正則化、音素境界に量子化精度を集中 | MDM-ASR 、 Unified ASR Transducer |
| データと評価 | 雑多な大規模データが小型モデルには害になる。書き起こしスタイル(どこまで忠実に書くか)の混在でWERが交絡 | 埋め込みによるデータ選択、書き起こしスタイル(どこまで忠実に書くか)をトークンで明示 | Which Data Matter 、 Transcription Policy |
深掘り①:Dixtral — LLMのチューニングではなく、音声エンコーダを改良
Grounding Spoken LLMs in Multi-Speaker Audio via Diarization Conditioning
課題:Speech-LLM型ASRを複数人の会話に対応させる従来手法は、話者ごとの発話を連結した1本の系列を出力するようLLM側のデコーダを再学習するもの(Serialized Output Training)でした。しかし再学習によって、LLMが元々持っていた言語能力を失う「破滅的忘却」が起きやすいという問題があります。
提案:LLM側には一切触らず、音声エンコーダを話者分離(ダイアライゼーション:誰がいつ話したかの推定)の結果を表すマスクで条件付けて、目標話者の音声だけを表す特徴を取り出します。ダイアライゼーション条件付きのWhisperエンコーダ(DiCoW)を、Mistral AIのSpeech-LLMであるVoxtralに組み込んだものがDixtralです。
結果・限界:会議・多話者の複数のベンチマークの話者付き書き起こしで、Gemini 3.0 Flash、VibeVoice、Voxtral Mini Transcribe V2を話者付きWER(cpWER。WERは単語誤り率)で大きく上回りました。新たに構築した長時間の多話者QAベンチマークでは、追加学習なしでも遠隔マイク音声の内容理解がGeminiと同等で、微調整後は近接マイク音声を使うGeminiやVoxtralを全タスクで上回っています。ただし、前段の話者分離の精度に全体が依存する構成でもあります。
位置付け:「LLMに何を任せ、何を外に出すか」という今回のASRの中心的な問いに対して、話者分離を外に出した代表例です。同じ発想で、アライメントをASR側に残すLLM-as-Joinerや、複数の音声エンコーダを前段で融合するSpeech Encoder Fusion(いずれも付録参照)が並んでいました。
深掘り②:Whisper Hallucination Steering — 内部表現からhallucinationを検出し、推論時に打ち消す
課題:Whisperは雑音や環境音だけの入力に対しても、入力とは無関係のもっともらしい文章を生成してしまうことがあります。常時マイクを開いている対話システムでは、この種のhallucinationがそのままLLMへの入力になるため、実用上の大きな問題です。
提案:Whisperの内部表現を調べると、音声エンコーダの活性化そのものと、それをSparse AutoEncoder(SAE:内部表現を少数の特徴に分解する手法)で分解した潜在表現の両方に、hallucinationに関する情報が線形分離可能な形で含まれていました。その識別力は少数の特徴に集中し、エンコーダの深い層ほど強くなります。そこで、活性化空間とSAE潜在空間のそれぞれで「hallucinationの方向」を推論時に打ち消すsteeringを提案しています。
結果・限界:SAEベースの方法では、非音声テストセット全体に対するhallucinationの発生率をWhisper small・large-v3のどちらでも大幅に下げました。音声データに対するWERの劣化は小さく、再学習を要する微調整ベースの手法に迫る性能です。
位置付け:再学習をせず推論時だけで改善する流れの代表例で、壊した入力との対照デコーディングで長文のhallucination・反復・脱落を抑えるWhisper-CD(付録参照)と同じ方向です。テスト時適応の手法を1つの定式化にまとめたRethinking Entropy Minimization(付録参照)も、運用中のデータに合わせて改善する点では近いですが、こちらは推論の前にテストデータでパラメーターを更新する方式で、推論処理だけで完結するsteeringやWhisper-CDとは区別されます。
短評
Unified ASR Transducer は、全部聞いてから認識するオフラインモードと、聞きながら認識するストリーミングモードを、1つのTransducer(RNNT:ストリーミング認識の定番構造)で両立させた研究です。学習時に両モードの出力が一致するよう正則化し、数百ミリ秒以下の低遅延でも精度を改善しつつオフライン性能を保ちました。もっとも遅延の小さい設定でも、ストリーミング専用モデルにわずかに劣る程度です。フレームワークと英語モデルが公開されているので、試しやすいのも魅力です。
COALA が扱うのは、人名や専門用語などの希少語を認識させるために候補語リストを与えるcontextual biasingです。Speech-LLMではリストをプロンプトに入れる形になりますが、リストが大きいほど性能が落ち、数千語規模ではメモリ不足で動かなくなります。COALAは、音声と各候補語の「含まれていそうな度合い」をスコア化して上位の少数の語だけをプロンプトに渡す方式で、大きなリストでも正解語のほぼすべてが上位候補に入り、希少語の認識誤りを大きく減らしました。キャラクター名やユーザー固有の語彙を扱う対話システムには、そのまま効きそうな知見です。
Transcription Policy as a Latent Variable は、「えー」や言い直しまで忠実に書くverbatimと、言いたかった内容だけを書くintendedという2つの書き起こしスタイル(どこまで忠実に書くか)が学習データに混在していると、デコードが不安定になり、報告されるWERのかなりの部分がスタイル不一致に由来すると見積もっています。デコーダー用のタスクトークンでスタイルを明示的に切り替えられるようにしたところ、英語データのみの学習でドイツ語の非流暢性検出の精度がゼロショットで大幅に上がりました。対話システムでは「言い淀みをLLMに渡すか」を設計で決めたいので、ASR側で切り替えられるのは便利です。
所感
ASRは精度向上から、「LLMと組み合わせた時に何を任せるか」「運用中のモデルを再学習なしでどう改善するか」へと問いが変わっている印象です。一方で、Speech-LLM型は話者数が少ないうちは従来のモジュール型パイプラインと競争できるものの、話者数や発話の重なりが増えると劣化するという系統的な評価(Who Spoke What When)も出ており、万能ではありません。
開発中のカスケード型システムでは、ASRはLLMへの入口です。無音・雑音でのhallucinationの抑制(steering、Whisper-CD)、キャラクター名などの希少語への対応(COALA)、オフラインとストリーミングの統一(Unified ASR Transducer)は、ASR部分だけを差し替えて試せる改良として優先度が高いと感じました。ASR部分をSpeech-LLM型に置き換えるかどうかは、多話者での頑健性を見ながら判断したいところです。
評価・データセット・ベンチマーク:「自然さ」だけでは測れない
概観
評価とデータセットの研究は、TTS・音声対話・ASRのどれにも関わる横断的なテーマです。これまで合成音声の評価は、評価者に5段階で自然さを採点してもらうMOS(Mean Opinion Score)一本に頼ることが多かったのですが、今回はその前提を見直す研究が目立ちました。研究の関心は次の3点に整理できます。
- 主観評価の設計:用途や文脈に応じた「適切さ」、評価者の属性による偏り、クラウドソーシング評価の品質管理、絶対評価ではなくペア比較で測るべき属性。
- 自動評価モデルの高度化と「報酬化」:予測の信頼区間を出す、局所的な韻律の誤りを捉える、人手ラベルなしで学習する、表現力のような抽象的な印象を測るといった高度化に加え、評価器を生成モデルの学習時の報酬として組み込む(TTSの節のFlowTTS-GRPOやVoiceTTAが「報酬を使う側」にあたります)。
- Speech-LLM・対話システムの新しい評価軸:複数の音声の聞き比べ、自然言語の指示による検索、音声で与えた指示への追従、声質の違いへの頑健性、会話の間合いの文脈判断。
Interspeech 2026で感じたキーワードは、「自然さだけの評価では不十分」「評価器の報酬化」「新しい評価軸」の3つです。データ構築では、48kHzステレオで110万時間超という大規模・高品質化のアプローチ(YODAS v3)と、複数のASRを統合して自動で注釈を付けるパイプライン(Balalaika)や、端末内で特徴量だけを抽出するプライバシー重視の収集(Collecting Prosody in the Wild)という実務寄りのアプローチの両方が進んでいました。論点ごとの整理を表4に示します。個々の論文は巻末の付録にまとめています。
表4:評価・データセット研究の論点と、Interspeech 2026で見られたアプローチ
| 論点 | これまでの主な課題 | 今回見られたアプローチ | 例 |
|---|---|---|---|
| 主観評価の設計 | 自然さMOS一本で、用途への適切さや感情の伝わり方が混ざる | 用途別の適切さ評価、音質と感情の分離採点 | Is Natural Always Appropriate 、 Listener Impressions |
| 評価者の偏りと品質管理 | 評価者属性の影響やクラウド評価の質が未検討 | 性別・アクセントによる偏りの分析、評価中・評価後のスクリーニング | MOS-Bias 、 Screening Matters |
| 絶対尺度のない属性 | 「らしさ」「表現力」を5段階では安定して測れない | ペア比較によるランキング学習、表現力の3要素分解とpreference alignment | AnimeScore 、 DeEAR |
| 自動評価モデルの信頼性 | 点推定のみ、局所誤りに鈍感、人手ラベルに依存 | 予測区間の出力、ピッチアクセント特化、学習ダイナミクスの擬似ラベル | ConformalMOS 、 PASQA |
| Speech-LLM・対話の評価 | 単一音声・テキスト指示での評価が性能を過大評価 | 複数音声の同時入力、音声指示、声質変動、意図つきの発話交代(ターン)の判断 | MUGEN 、 CoDeTT |
| データ構築 | 低帯域のモノラル中心、人手注釈とプライバシーのコスト | 高帯域ステレオの超大規模データ、複数ASRの統合による自動注釈、端末内での特徴抽出 | YODAS v3 、 Balalaika 、 Collecting Prosody in the Wild |
深掘り①:Is Natural Always Appropriate — 「自然」と「その場にふさわしい」は別物
課題:TTSの評価は長らく「自然さ」を主目標にしてきましたが、オーディオブックに最適な声が、AIアシスタントやアニメキャラクターにふさわしいとは限りません。キャラクターらしさを売りにするプロダクトでは、自然さだけで測ると肝心の部分が評価から抜け落ちます。
提案:5つの最先端TTSシステムを、AIアシスタント・朗読・俳優・アニメキャラクター・自発話者の5ドメインで、「適切さ」と「人間らしさ」の両面から測定しました。
結果・限界:適切さの評価は自然さとは独立にドメイン間で変動し、朗読で優秀なシステムも表現的なドメインでは依然として難しく、1つのドメインに最適化すると他が劣化しうることが分かりました。さらに自然さスコアには、様式化された話し方を減点し自発的な話し方を加点する傾向があり、画一的な指標は表現力豊かな音声ドメインで制約があります。
位置付け:用途次第でTTS評価が変わるという主張で、音質と感情を分けて採点するListener Impressions(MOS予測モデルの共通評価の場であるVoiceMOS Challenge 2026で、感情TTSを対象とするTrack 2のデータに使われています)や、用途別の評価プロトコルへ移る流れの一環です。私たちにとっては、キャラクター音声を「自然か」ではなく「そのキャラクターらしいか」で評価する社内の聴取試験(評価者が音声を聞いて採点する主観評価)の設計に直結する内容でした。
深掘り②:AnimeScore — 「アニメ声らしさ」とは
AnimeScore: A Preference-Based Dataset and Framework for Evaluating Anime-Like Speech Style
課題:「アニメらしい声」の評価は高コストな主観評価に頼っており、標準的な客観指標がありませんでした。しかもアニメらしさは、自然さと違って評価者の間で共有された絶対尺度がないため、5段階採点では安定しません。
提案:絶対評価をやめ、「どちらがよりアニメらしいか」のペア比較でランキングを学習する枠組みです。日本語の公開コーパス(アニメ関連の音声と一般音声)を素材に、多数の評価者から大量のペア判定を、自由記述の理由とともに収集しました。
結果・限界:音響分析では、知覚されるアニメらしさは単に声が高いことではなく、共鳴の作り方、韻律の連続性、意図的な調音で決まることが示されました。評価モデルは、手設計の音響特徴では判別精度に限界があったのに対し、自己教師あり学習(SSL)表現に基づくランキングモデルは大幅に高い判別精度に達しています。
位置付け:評価器をそのままpreference optimizationの報酬に転用できる設計で、TTSの節で触れた「出力音声に求める知覚的な性質を報酬として与える」流れの、評価側にあたる研究です。表現力を3要素に分解して少量の人手評価で人の感覚に合わせるDeEAR(後述)も同じ方向です。キャラクター音声を扱う私たちには、「らしさ」をペア比較で集めて報酬にする、という手順そのものが参考になります。
短評
CoDeTT は、ターンテイキングの評価を「ユーザー発話が終わったか」の二値判定ではなく、対話の文脈とシステムの状態を条件に、続ける・止まって聞く・引き取る・無視するの4つの行動を選ぶ決定問題として定式化し、背後の意図を表す細かな診断層を加えたベンチマークです。中英二言語の大規模な対話から作ったデータでGemini 3 Pro、GPT-4o-audio、Qwen3-Omniなどを評価し、「止まる」という行動は正しくても、割り込みを聞き取ったからではなく履歴の慣性で止まっている、といった理由の誤りを検出しました。音声対話の節で挙げたSpeak or Stay Silentや、DualTurn(付録参照)のような発話交代を判断するモデルを「評価する側」の研究です。
PASQA が対象にするのは、日本語の「箸/橋」のような局所的なピッチアクセント誤りで、発話全体の自然さを1つの値で予測する既存のMOS予測モデルでは見逃されがちな問題です。アクセントを制御できるTTSでわざと誤りを作った音声で学習した専用の評価モデルで、モーラ単位の情報の統合、誤りの深刻さの順序を学ぶランキング損失、誤り位置の推定を組み合わせ、既知・未知話者の双方で誤りの深刻さの順序を高い精度で再現し、人のアクセント正誤判定とも既存モデルより強く一致しました。コードはLINEヤフーから公開されています。
DeEAR は、聞き取れても平板になりがちな音声対話モデルの出力に対して、これまで指標のなかった「表現力」を測る枠組みです。表現力を感情の強さ・韻律・自発らしさの3次元に分解し、次元ごとのスコアを統合して人の選好に合わせます。少量の注釈サンプルで人の知覚と高い相関を示し、システム間の順位も人のMOSとよく一致しています。さらに評価器で選別した発話で学習すると、表現力スコアが大幅に改善しました。評価器を「測る道具」から「データを選び、報酬を与える道具」に変えた例です。
所感
評価の研究が「自然さMOS一本」から「用途別・多次元・ペア比較」へ動いているのは、TTSの品質が実用水準に達したことの裏返しだと感じました。自動評価器が報酬として学習に組み込まれる流れは便利な反面、評価器に残った偏り(MOS-Biasが示した、評価者の性別による採点差など)がそのまま生成モデルに伝播するリスクも明確になっています。
現地での交流
Interspeechに参加したもう1つの目的は、音声分野の研究者・技術者とのコネクションづくりでした。ここでは、とくに印象に残ったやりとりと、バンケットの様子を紹介します。
研究者・学生との交流
日本の研究者
大学院時代の研究室の同期・先輩後輩や、その人たちが現在所属する会社(SonyやLINEヤフー)のメンバーとは、学会中の食事をともにしながら、研究・開発に関する議論、情報共有を行いました。
日立やNTT、サイバーエージェントなどの研究職の方々とも、立ち話をしたり、気になる発表を一緒に聴いて回ったりしました。同じ発表を見ても注目する点が人によって違い、一人で回るより多くのことを拾えた感覚があります。
海外から東京の大学の研究室に留学中で、来年からイギリスの大学の博士課程に進むという方とも知り合いました。日本の研究室を経て海外の博士課程へ進むという経路は新鮮で、研究者のキャリアの多様さを感じました。
海外の企業・研究チーム
台湾の音声研究室からは多くの方が参加していて、レセプションなどで交流して盛り上がりました。
一番面白かったのは、夜に飲食店で開かれた有志の交流会で知り合った、チェコのとある省庁で働く方々です。音声のセキュリティを扱っていて、情報収集のために毎年Interspeechに参加しており、もう10年近くになるそうです。研究者でも企業の開発者でもない参加者がいること自体が新鮮で、家族や趣味の話まで含めてすっかり盛り上がりました。
学生・若手
東京大学や東京科学大学、慶應義塾大学などの研究室で音声領域の研究に取り組む学生たちと話す機会もありました。DeNAでTTSの開発をしていることや、聴講でも国際会議に参加できる制度があることを話すと、どちらもあまり知られておらず、驚いている人が多かったです。発表がなくても定期的に国際会議に参加できる会社は珍しいようで、よい周知の機会にもなったと思います。
ポスター発表での議論
ポスター発表では、評価・データセットの節で触れた2本の論文の著者と直接議論できました。
A Large-Scale Dataset of Listener Impressions of Emotional TTSのポスターにて
A Large-Scale Dataset of Listener Impressions of Emotional TTSでは、第一著者のErica Cooperさん(NICT:情報通信研究機構)と議論しました。日本でもよく知られた音声研究者で、音声合成の評価を専門にされています。
YODAS v3のポスターにて
YODAS v3: Over 1 Million Hours of High-Bandwidth, Stereophonic, Multilingual Speechでは、情報技術の分野で有名なCarnegie Mellon Universityの第一著者の方と、大規模データでのTTS学習について議論しました。著者によると、前のバージョンのデータセットでTTSの学習を試したことがあり、このデータセットをTTS学習に使うにはデータフィルタリングが重要とのことでした。前処理には、オープンソースの音声生成向けデータセットである Emilia に含まれる、in-the-wild音声を学習用に整える前処理パイプライン(Emilia-Pipe)を使っているそうです。大規模データを「集める」ことと、「使える形に選ぶ」ことは別の仕事だと、改めて感じた議論でした。
バンケット
さまざまな海鮮料理が並んだ。生牡蠣が印象的だった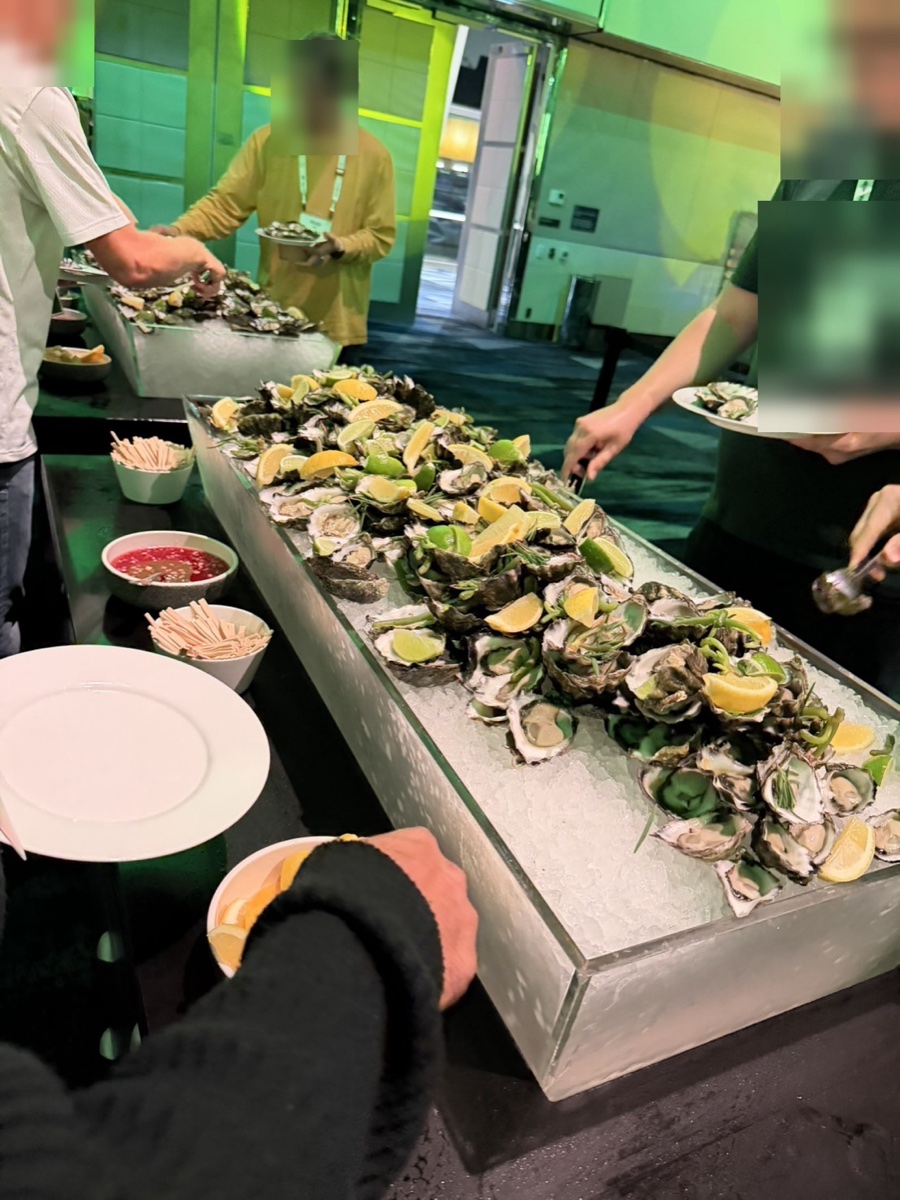
会期中のバンケットでは、さまざまな海鮮系の料理が並び、とくに生牡蠣が出てきたのが印象的でした。デザートも充実していました。現地の民族的なパフォーマンスやバンド演奏もあり、演奏の途中からは参加者が会場の真ん中に集まって踊る時間もありました。大学院時代に参加したときは私自身も輪の外から眺めていたのですが、今回は踊っている日本人の参加者も多く、雰囲気の変化を感じました。
バンド演奏に合わせて踊る参加者たち
持ち帰った学び
「はじめに」で挙げた2つの問い(最新技術はどこまで進んでいるか/開発中のシステムや今後の新規プロダクトに活かせる技術はあるか)に、現時点での答えをまとめます。
最新技術はどこまで来ているか
- TTSは、ゼロショット合成の自然さ・話者性が実用水準に達し、研究の重心はhallucination・長文崩れの抑制、単語単位・時間変化の制御、少ステップ化・ストリーミングによる低遅延化に移り、制御を学習させる道具としてpreference optimization(DPO/GRPO)が定着しつつあります。
- 音声対話は、終端を「当てる」から「先読みして準備する」「相づちか応答かを判断する」「誰に向けた発話かを判断する」へ進む一方、評価はまだテキスト・自動指標が中心で、音声として人がどう感じるかはこれからです。
- ASRは、Speech-LLM型が標準になる中で、話者分離やアライメントをLLMの外に出す役割分担と、再学習なしでhallucinationを抑える推論時の介入に関心が移り、多話者での頑健性はまだ課題として残っています。
- 評価は、自然さMOS一本から用途別の適切さ・ペア比較・多次元の評価へ広がり、評価器を学習の報酬に使う流れが定着しつつある一方、評価器の偏りが生成モデルに伝播するリスクも見えてきました。
開発中のシステムや今後の新規プロダクトに活かせる技術
各節の所感で触れた研究のうち、業務で活用できそうなものを活用先ごとにまとめます。多くは、開発中のカスケード型システムの構成を変えずに、部品の差し替えや評価の追加で試せるものです。試す順番は、構成を変えずに部品単位で差し替えられ、応答遅延のように効果が体感に直結するものから、と考えています。
| 研究 | 活用先 | 期待する効果 |
|---|---|---|
| 終端の先読みと投機実行(speculative execution、Endpoint Anticipation) | 対話システム | 応答遅延の大幅な短縮 |
| 音響+韻律に絞った終端検出(Less can be More) | 対話システム | 早すぎる終端検出の抑制。ASR出力への依存を減らせる |
| 相づちの機能別タイミング、相づちか応答かの判断(DP-BCT、Considerate Listener) | 対話システム | キャラクターらしい「聞き方」 |
| ストリーミングTTS+単語単位のスタイル制御(FlashTTS、CraftTTS) | 対話システム・TTS開発 | 体感遅延の短縮と話し方の演出の両立 |
| 推論時適応(VoiceTTA) | TTS開発 | 参照音声の再現性向上 |
| 無音・雑音でのhallucinationの抑制(Whisper Hallucination Steering、Whisper-CD) | 対話システム(ASR) | 常時マイクを開く環境での誤入力の削減。再学習なしで適用できる |
| 希少語の絞り込み(COALA) | 対話システム(ASR) | キャラクター名やユーザー固有の語彙の認識 |
| オフラインとストリーミングの統一(Unified ASR Transducer) | 対話システム(ASR) | 1モデルで低遅延と高精度を両立。フレームワークと英語モデルが公開済み |
| 用途別の適切さ評価とペア比較(Is Natural Always Appropriate、AnimeScore) | 評価・品質管理 | 「キャラクターらしさ」を測る聴取試験の設計と、preference optimizationの報酬化 |
| ピッチアクセント特化の評価器(PASQA) | 評価・品質管理 | 日本語TTSのアクセント誤りの自動検出 |
| 意図つきの発話交代(ターン)判断のベンチマーク(CoDeTT) | 評価・品質管理 | 発話交代の制御を「なぜそう判断したか」まで診断 |
| 依頼から発話内容ごと生成(Bagpiper-TTS)、音声ドラマの一括制作(AuDirector) | その他 | 台本なしの音声コンテンツ生成 |
| 聞き手ごとの知覚への適応(Beyond One-Size-Fits-All) | その他 | ユーザーに合わせた感情表現の個人化 |
| 端末上の小型音声言語モデル( Samsone ) | その他 | オフライン・低コストでの音声対話 |
表の最後のSamsoneは本文の節では触れていませんが、端末上で動く小型の音声言語モデル(99M〜356Mの3サイズ)を公開データのみで学習し、学習コード・重み・Android向けのデモアプリまで公開している研究で、オフライン・低コストの音声対話の足がかりとして試しやすいと感じました。
おわりに
Interspeech 2026は、過去最多の参加者と発表件数にふさわしく、音声合成・音声対話の両方で「次に解くべき問題」がはっきり見えた会議でした。終端の先読み、音響+韻律に絞った終端検出、ストリーミングTTSと細かなスタイル制御は、開発中の音声コンパニオンでまず試してみたい技術です。
現地で議論に付き合ってくださった研究者の皆さん、参加を後押ししてくれた会社とチームに感謝します。音声AIに関わるエンジニアの方に、Interspeechの「いま」が少しでも伝われば嬉しいです。音声対話システムの開発に興味のある方は、ぜひBAKERUの取り組みものぞいてみてください。
付録:Interspeech 2026 注目論文リスト
今回見た中で注目した論文を論点別にまとめました。各論文名はISCA Archiveの論文ページにリンクしています。
TTS
- One-Step Token-to-Waveform Generation with MeanFlow in Latent Space
- DiFlow-TTS: Compact and Low-Latency Zero-Shot Text-to-Speech with Discrete Flow Matching
- DLLM-TTS: Block Discrete Diffusion Language Model for Text-to-Speech Synthesis
- Decoding Order Matters in Autoregressive Speech Synthesis
- TC-DBI: A Plug-and-Play Trajectory Confidence-Guided Dynamic Block Inference Strategy for Speech Synthesis with Continuous Block Flow Matching
- RobustSpeechFlow: Learning Robust Text-to-Speech Trajectories via Augmentation-based Contrastive Flow Matching
- Eliminating Stability Hallucinations in LLM-based TTS models via Attention Guidance
- MagpieTTS-LF: Inference-Time Long-Form Speech Generation Without Training on Long-Form data
- CraftTTS: Fine-Grained Prosody Control for Text-to-Speech
- Continuous Time-Varying Emotion Control Zero-Shot Text-To-Speech With Emotion Orthogonal LoRA(EO-LoRA)
- FineCombo-TTS: Collaborative and Precise Controllable Speech Synthesis Using Text Descriptions and Reference Speech
- Beyond One-Size-Fits-All: Personalized and Culturally Adaptive Emotional TTS via Interactive Optimization of Individual Emotion Perception Spaces
- Emo-BPO: Emotion Bidirectional Preference Optimization for Diffusion-based Emotional TTS
- FlowTTS-GRPO: Online Reinforcement Learning with Multi-Objective Reward Optimization for Flow-Matching Based Text-to-Speech
- VoiceTTA: Enhancing Zero-Shot Text-to-Speech via Reinforcement Learning-Based Test-Time Adaptation
- Edit Content, Preserve Acoustics: Imperceptible Text-Based Speech Editing via Self-Consistency Rewards
- CTC-TTS: LLM-Based Dual-Streaming Text-to-Speech with CTC Alignment
- FlashTTS: Fast Streaming TTS with MTP Acceleration and X-pred Mean Flow Distillation
- Prosodic Boundary-Aware Streaming Generation for LLM-Based TTS with Streaming Text Input
- Not Quite My Tempo: Voice Activity-aware Speech Synthesis for Lip-Synchronous Dubbing
- Bagpiper-TTS: Natural Language Guided Universal Speech Synthesis
- AuDirector: A Self-Reflective Closed-Loop Framework for Immersive Audio Storytelling
音声対話
- Endpoint Anticipation for Low-Latency Spoken Dialogue
- TASTE-Streaming: Towards Streamable Text-Aligned Speech Tokenization and Embedding for Spoken Language Modeling
- Less can be More: What Aspects of Speech Drive End-of-Turn Detection
- Adaptive Turn-Taking for Real-time Multi-Party Voice Agents
- Speak or Stay Silent: Context-Aware Turn-Taking in Multi-Party Dialogue
- Considerate Listener Modeling for Korean Streaming Backchannel Prediction
- DP-BCT: A Dual-Path model for predicting BackChannel Timing
- TurnGuide: Enhancing Meaningful Full Duplex Spoken Interactions via Dynamic Turn-Level Text-Speech Interleaving
- UniVoice: Unifying Autoregressive ASR and Flow-Matching based TTS with Large Language Models
- Integrating Facial Generation into Full-Duplex Spoken Dialogue Systems
- DualTurn: Learning Turn-Taking from Dual-Channel Generative Speech Pretraining
音声認識
- Grounding Spoken LLMs in Multi-Speaker Audio via Diarization Conditioning(Dixtral)
- LLM-as-Joiner: Decoupling Alignment from Language Modeling in Label-synchronous ASR
- Speech Encoder Fusion for LLM-based Automatic Speech Recognition
- COALA: Robust Contextualized Speech-augmented Language Modeling for ASR via Contrastive Regularizer and Biasing Score Estimation
- Can Large Language Models Reliably Correct Errors in Low-Resource ASR? A Contamination-Aware Case Study on West Frisian
- Whisper Hallucination Detection and Mitigation via Hidden Representation Steering and Sparse AutoEncoders
- Whisper-CD: Accurate Long-Form Speech Recognition using Multi-Negative Contrastive Decoding
- Rethinking Entropy Minimization in Test-Time Adaptation for Autoregressive Models
- HALAS: A Human-Annotated Dataset of Hallucinations of Modern ASR Systems
- Gender Bias in ASR: A Controlled Study of Gender Composition Across Training Paradigms
- Who Spoke What When? Evaluating Spoken Language Models for Conversational ASR with Semantic and Overlap-Aware Metrics
- Mind the Gap: Impact of Synthetic Conversational Data on Multi-Talker ASR and Speaker Diarization
- Multi-Talker ASR Unaffected by Speaker Change Count
- Speaker-Aware Hypothesis Clustering and Merging for Target-Speaker-free and Target-Speaker Multi-Talker ASR(Speaker-Aware HCM)
- Pushing the Boundaries of Streaming Multi-Speaker ASR: A Systematic Study of Architectural Trade-offs
- MDM-ASR: Bridging Accuracy and Efficiency in ASR with Diffusion-Based Non-Autoregressive Decoding
- Non-Autoregressive Minimum Bayes’ Risk Decoding for Fast Speech Recognition
- Reducing the Offline-Streaming Gap for Unified ASR Transducer with Consistency Regularization
- Not All Frames Are Equal: Difference-Aware Quantization for Ultra-Low-Bit ASR
- Pruning as Regularization: Sensitivity-Aware One-Shot Pruning in ASR
- Pushing the Limits of Compression: Sub-1-Bit Conformer via Variable-Rank Binary Decomposition(LittleASR)
- Which Data Matter? Embedding-Based Data Selection for Speech Recognition
- Transcription Policy as a Latent Variable: Activating Controllable Verbatim ASR with Word-Level Timing
評価・データセット
- Investigating Faithfulness in Large Audio Language Models
- From Awareness to Adherence: Bridging the Context Gap in Spoken Dialogue Systems via Context-Aware Decoding
- From Reactive to Proactive: Assessing the Proactivity of Voice Agents via ProVoice-Bench
- Is Natural Always Appropriate? Investigating Naturalness and Appropriateness Across Different Domains for TTS Evaluation
- A Large-Scale Dataset of Listener Impressions of Emotional TTS
- MOS-Bias: From Hidden Gender Bias to Gender-Aware Speech Quality Assessment
- CodecMOS-Accent: A MOS Benchmark of Resynthesized and TTS Speech from Neural Codecs Across English Accents
- Screening Matters: A Comparative Study of Conventional and Crowdsourced Listening Tests
- AnimeScore: A Preference-Based Dataset and Framework for Evaluating Anime-Like Speech Style
- Decoding the Ear (DeEAR): A Framework for Objectifying Expressiveness from Human Preference Through Efficient Alignment
- PASQA: Pitch-Accent-Focused Speech Quality Assessment Model Trained on Synthetic Speech with Accent Errors
- ConformalMOS: Uncertainty-Aware MOS Prediction with Conformal Intervals and Ordinal Modeling
- TDScore: Learning Synthetic Speech Quality Predictors from TTS Training Dynamics without Human annotation
- NV-Bench: Benchmark of Nonverbal Vocalization Synthesis for Expressive Text-to-Speech Generation
- CoDeTT: A Context-Aware Decision Benchmark for Turn-Taking Evaluation
- MUGEN: Evaluating and Improving Multi-audio Understanding of Large Audio-Language Models
- INSPIRE: A Benchmark for Instruction-Aware Speech Retrieval
- Do What I Say: A Spoken Prompt Dataset for Instruction-Following
- Lost in Phonation: Voice Quality Variation as an Evaluation Dimension for Speech Foundation Models
- Rethinking Speech Foundation Model Fine-tuning: Better SFT or Better Match?
- YODAS v3: Over 1 Million Hours of High-Bandwidth, Stereophonic, Multilingual Speech
- Balalaika: Data-Centric, Prosody-Aware Annotation Pipeline for Russian Speech
- Collecting Prosody in the Wild: A Content-Controlled, Privacy-First Smartphone Protocol and Empirical Evaluation


最後まで読んでいただき、ありがとうございます!
この記事をシェアしていただける方はこちらからお願いします。