


はじめに
こんにちは! DeNAでAIスペシャリストのサマーインターンシップに参加していた北田果耶です!
DeNAのインターンシップには、機械学習を社会実装としてやってみたいということと、その中でもモデルがプロダクトにどう影響を与えるのかを実務を通して経験したいという思いで応募しました。本記事では、私がインターンシップで取り組んだ内容や学びについてお話しします。
自己紹介
大阪大学大学院修士1年生の北田 果耶(キタダ カヤ)です!
大学ではコンピュータサイエンスを専攻しており、ソフトウェア工学タスクにおけるAI活用に関する研究をしています。
機械学習については大学の授業で学んだ経験のみで、今回のインターンシップではじめて本格的なデータサイエンスに取り組みました。
本記事の内容
今回のインターンシップでは、次の2つのタスクに取り組みました。
- あるユーザーがある問題をどの程度解くことができるのかを、確率で予測するモデルの開発
- その予測を使って、ユーザー一人ひとりの学習計画を立てる仕組みの設計
本記事ではとくに、
- 新規プロダクトにおける機械学習の活用
- モデルの予測をプロダクトにどう組み込むか
という2つのポイントに焦点を当てて、具体的な挑戦と学びをお伝えできればと思います。
こんな人に読んでほしい
- DeNAのAIスペシャリストに興味のある方
- プロダクトに合った機械学習の組み込み方に興味がある方
の参考になれば幸いです!
扱ったサービスの紹介
概要
今回のサマーインターンシップでは、DeNAが提供している大学受験アプリ「SIRUS」を題材に、機械学習モデルの開発に取り組みました。SIRUSは大学受験で、数学の記述対策が必要な受験生のためのアプリです。ユーザーはアプリで表示される記述式の問題を手元の紙で解き、撮影して提出します。その答案をAIが採点します。志望校を登録すると、その大学の出題傾向に合わせた学習計画が立てられ、毎日取り組む問題がオススメとして届きます。
ユーザーの実力測定における現状
このオススメを一人ひとりに合ったものにするには、ユーザーがいまどのくらいの実力で、どの問題を解くと、合格に近づいていきやすいかを見積もる必要があります。そこで今回取り組んだのが、
「ユーザーの学習履歴から次の1問をどの程度解くことができるのかを予測し、そのユーザーに最適な難易度の問題を出題する」というテーマでした。
このテーマに取り組むために用いたのが、Knowledge Tracing(KT)という手法です。KTは、どの問題でどの程度解くことができたのかという解答の履歴から、学習者の知識の状態が時間とともにどう変わっていくかを追跡し、次に解く問題をどの程度解くことができるのかを予測する手法です。今回採用したモデルでは、この知識の状態を「実力」という数値で表し、ユーザーが1問解くたびにその結果から実力の推定を更新して、次に解く問題の正解確率を出します。
SIRUSでは、答案をAIが25点満点で採点し、部分点も含めたスコアを返します。今回のKTでは、評価指標を計測するうえで20点以上を「正解」とし、次の問題で20点以上を取れる確率を予測します。答案を正解・不正解に判定するモデルではなく、どの程度解けそうかを確率で見積もるモデルです。同じユーザーでも、易しい問題なら9割、難しい問題なら1〜2割、というように問題ごとに解ける確率が出ます。
このテーマの面白さであり、難しさは使えるデータの規模にありました。分析に使った時点の解答ログは数百人・数千件規模で、研究で使われるKTのベンチマークと比べると2〜3桁小さいデータです。ユーザーごとの解答数のばらつきも大きく、数問しか解いていないユーザーに対しても、出題の判断に使える確率を出す必要がありました。
このような状況下で、いかにしてモデルを構築し、精度を確保し、さらにはプロダクトの改善に繋げていくか。このデータ制約の中で最適なアプローチを探るのが、私のインターンシップの大きなテーマとなりました。
予測モデルの構築と選定プロセス
モデルの採用と構成
最終的に採用したのは、Eloレーティングで出した確率を、ロジスティック回帰で補正する二段構成のモデルです。全体の流れは下の図のとおりです。
採用モデルの計算の流れ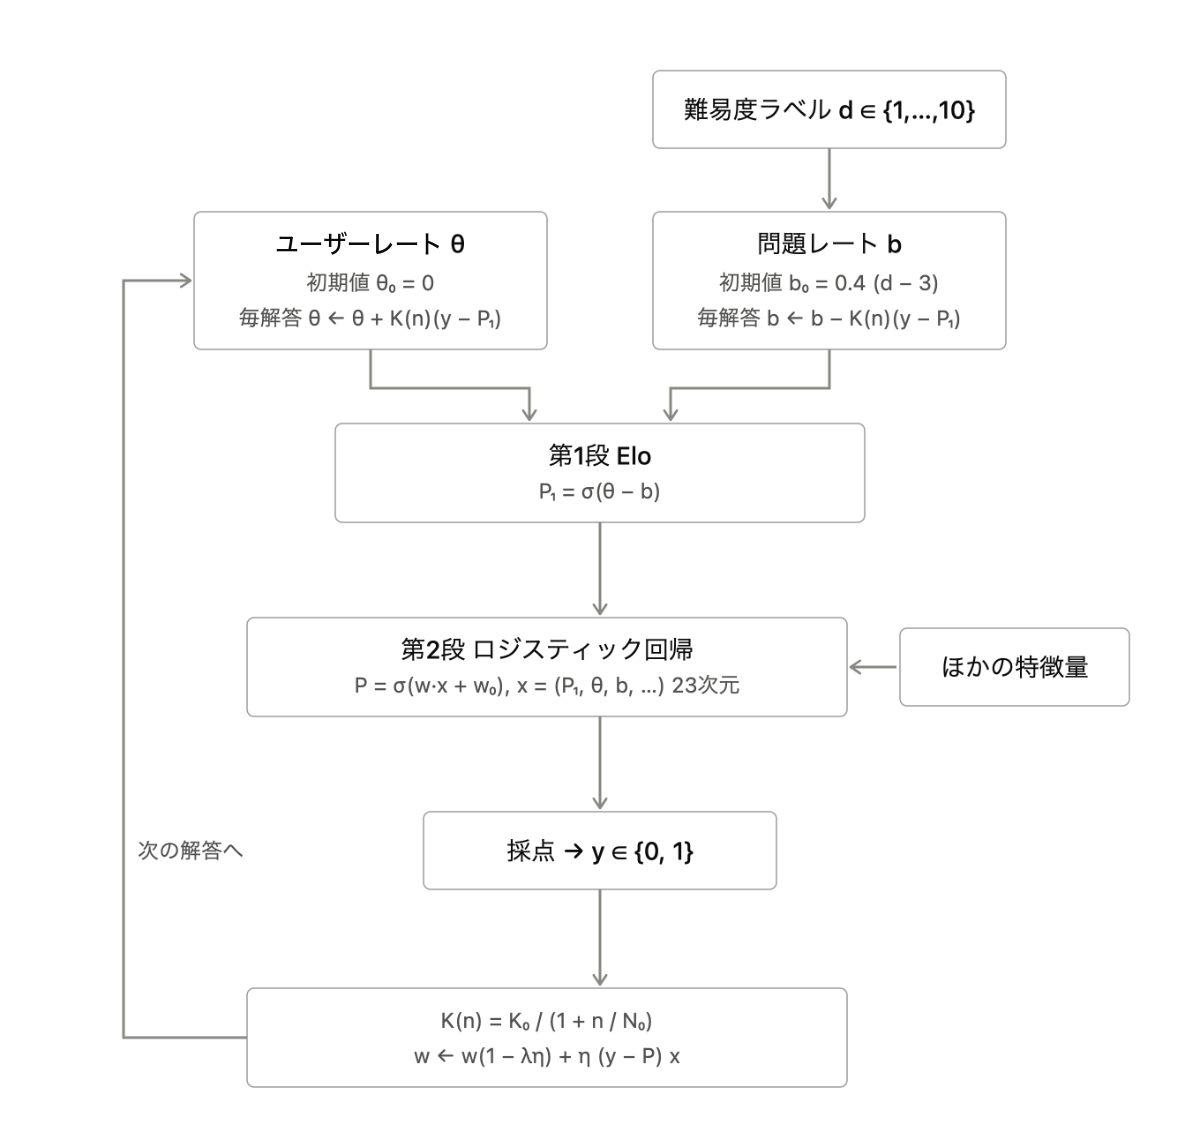
第1段では、ユーザー $u$ の実力を $\theta_u$(ユーザーレート)、問題 $i$ の難しさを $b_i$(問題レート)という1つの数値で表し、その差から正解確率を出します。
$$ P_1 = \sigma(\theta_u - b_i), \qquad \sigma(z) = \frac{1}{1 + e^{-z}} $$
チェスのレーティングと同じ考え方で、実力と難しさが同じなら50%になり、実力が上回るほど確率が上がります。新しいユーザーは $\theta_u = 0$ から始め、新しい問題は人手で付与された難易度ラベル $d_i$(1〜10)から初期値を作ります。
$$ b_i^{(0)} = 0.4 (d_i - 3) $$
この初期化の式は、実データから推定した難易度ラベルと問題レートの関係とほぼ重なることを確認しています。初期値はあくまで出発点で、その後は解答データで自動的に補正されます。
第2段では、$P_1$・$\theta_u$・$b_i$ に、問題側の情報や直近の解答の傾向などの特徴量を加えたベクトル $\mathbf{x}$ を入力にして、ロジスティック回帰で最終的な正解確率 $P$ を出します(特徴量は23個で、切片 $w_0$ は別に持ちます)。
$$ P = \sigma(\mathbf{w}^\top \mathbf{x} + w_0) $$
Elo単体は安定しているものの直近の解答の傾向を反映できず、回帰単体はユーザーや問題ごとのレートを持たないため新しい問題に弱いという弱点があります。第1段の出力を第2段の入力にすることで、両方の弱点を補っています。出題の判断に使うのは、この $P$ です。
答案が採点されて正誤 $y$(20点以上なら1、それ以外は0)が分かったら、その場で状態を更新します。レートは第1段の誤差 $y - P_1$ の分だけ、ユーザーと問題を逆向きに動かします。
$$ \theta_u \leftarrow \theta_u + K(n_u)(y - P_1), \qquad b_i \leftarrow b_i - K(n_i)(y - P_1) $$
$$ K(n) = \frac{K_0}{1 + n / N_0} $$
予想より解けたらユーザーの実力は上がり、その問題は易しかったとして難しさが下がります。更新幅 $K(n)$ は、そのユーザー(または問題)の観測数 $n$ が増えるほど小さくなります(今回は $K_0 = 0.8$、$N_0 = 40$)。そのため、新しいユーザーは少ない解答でも推定値が大きく動き、データが溜まったユーザーは急に動きません。回帰の重みは、第2段の誤差 $y - P$ を使って、L2正則化つきの確率的勾配降下法で1ステップずつ更新します。
$$ \mathbf{w} \leftarrow \mathbf{w} + \eta \left( (y - P)\mathbf{x} - \lambda \mathbf{w} \right) $$
ここで $\eta$ は学習率、$\lambda$ は正則化の強さです。
モデルの選定評価
モデルの選定にあたっては、採用モデルを含む8つの構成を同じ条件で比較しました。主指標には、予測確率の良さを測るlog-lossを使いました。
$$ \text{log-loss} = -\frac{1}{N} \sum_{t=1}^{N} \left[ y_t \log P_t + (1 - y_t) \log (1 - P_t) \right] $$
$y_t$ は $t$ 番目の解答の正誤(1か0)、$P_t$ はその解答の前にモデルが出した正解確率です。正解したのに低い確率を出していたり、不正解だったのに高い確率を出していたりするほど大きな値になるので、確率そのものがどれだけ当たっているかを測れます。あわせて、正誤を当てた割合(accuracy)と、後述するキャリブレーションも見ました。
評価は、ある日付より前のデータで学習し、それより後のデータで評価する時系列分割で行いました。評価期間のログは時系列に再生し、各解答の直前までの情報だけで予測してから状態を更新する、本番と同じ順序にしています。比較の基準として、すべての解答を「解ける」と予測するベースラインも並べました。評価期間の解答は約7割が20点以上だったため、すべて「解ける」と答えるだけでもaccuracyは0.711になります。確率を出さないため、log-lossは計算していません。
結果は次のとおりです。下の行ほどlog-lossが良い順に並べています。
| 構成 | accuracy | log-loss | 判断と再評価の条件 |
|---|---|---|---|
| ベースライン(すべて「解ける」と予測) | 0.711 | — | 比較の基準 |
| BKT(Bayesian Knowledge Tracing) | 0.641 | 0.662 | 単元より細かい知識の単位でデータが取れたら再評価 |
| 過去の正解率 | 0.618 | 0.639 | 比較用 |
| 深層学習を用いたKT(DKT) | 0.652 | 0.624 | データが1桁以上増え、1人あたりの解答数も大きく増えたら再評価 |
| 項目反応理論(IRT)+Elo+ロジスティック回帰 | 0.722 | 0.573 | 新しい問題に対応できないため不採用(後述)。問題がほとんど増えない運用になったら再評価 |
| 勾配ブースティング+Elo | 0.729 | 0.558 | データが数倍になったら再評価 |
| カスケード(初出の問題だけEloで予測) | 0.744 | 0.525 | 採用モデルに届かず不採用 |
| 採用モデル(Elo+ロジスティック回帰) | 0.758 | 0.519 | 採用 |
表の値は、すべての構成を同じ条件(評価期間中は回帰の係数を固定)で比べたものです。採用モデルを本番と同じく解答ごとのオンライン更新で動かすと、log-lossはさらに0.502まで下がりました。
表からわかるのは、効いているのはレーティング($\theta$ と $b$)だということです。ベースラインのaccuracyを上回った構成は、すべてEloのレーティングを含んでいました。DKTやBKTはベースラインのaccuracyに届かず、今回のデータ量では、解答の系列から上達の過程を学習するには足りないのだと考えています。
大規模言語モデル(LLM)による予測は、200件の解答で評価しました。同じ200件で比べると、accuracyは0.650とベースライン(0.615)を上回りましたが、log-lossは0.805と比較した中でもっとも悪く、採用モデル(0.617)に大きく劣りました。0.9や0.08のような極端な確率を出しがちで、外したときの損失が大きくなるためです。学習計画は確率そのものを入力に使うので、accuracyだけでは選べません。また、LLMは単体では学習しないため、データが増えても精度は伸びません。
IRTを含む構成が伸びなかった理由は、問題の難しさの推定方法にあります。IRTは問題の難しさを学習データからまとめて推定するため、学習期間に出てこなかった新しい問題には難しさを与えられません。時系列分割では、評価期間にはじめて出てくる問題もそのまま予測することになるので、この弱点が結果に表れます。一方でEloは、冒頭の二段構成のモデル図で示したとおり、新しい問題でも難易度ラベルから初期値 $b_i^{(0)}$ を作ってすぐに更新を始めるので、問題が追加されても精度が落ちにくいです。
表の右端の「再評価の条件」は、採用しなかった手法を、データがどれだけ増えたら再評価すべきかの目安です。いまのデータ量では採用モデルに劣っていても、データが増えれば上回る手法もあります。そこで、学習に使うデータを全体の一部に減らしながら精度を測り、データ量と精度の関係(学習曲線)を描きました。その曲線を外挿して採用モデルを上回るデータ量を求め、再評価の目安にしています。
予測確率と実際の正解率(左:人手の難易度ラベルのみ、右:採用モデル)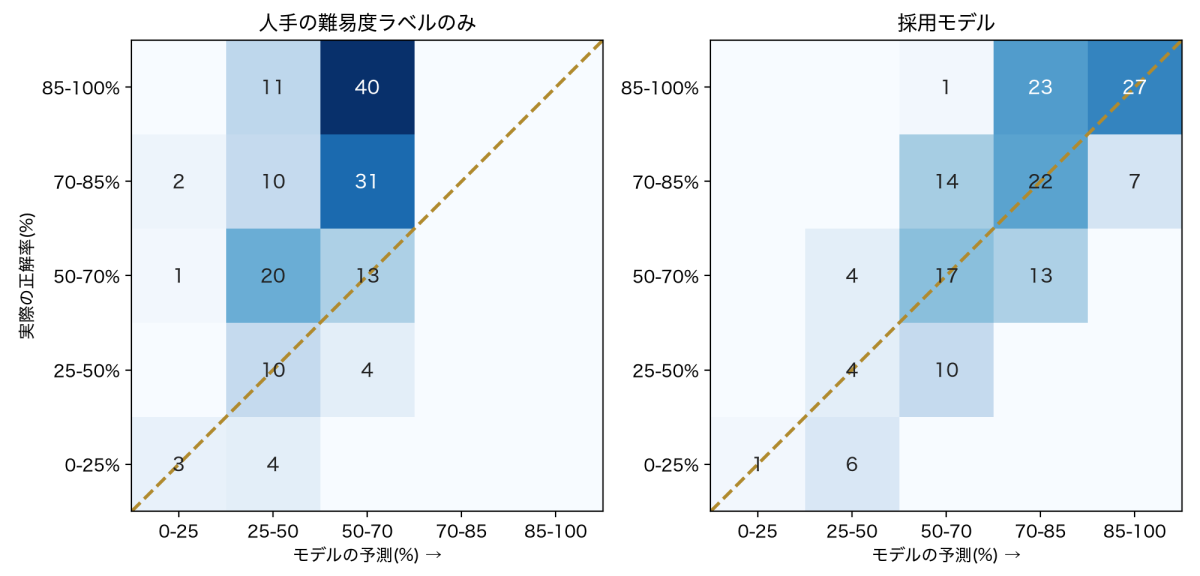
あわせて、予測確率そのものが信頼できるか(キャリブレーション)も確かめました。「70%と予測した問題が、実際に70%正解されているか」を見るもので、後半で予測確率をそのまま出題の判断や学習計画の入力に使うため、とくに重視しました。
上のヒートマップは、評価期間の解答をユーザー×難易度ごとに(5件以上のものだけ)まとめ、予測の平均と実際の正解率の組み合わせを数えたものです。破線の対角線に近いほど、予測どおりに当たっていることを表します。右が採用モデル、左が比較のために人手の難易度ラベルだけで予測した場合です。左のモデルは、入力を難易度ラベル1つだけにしたロジスティック回帰で、ユーザーの実力や解答の履歴は使っていません。どちらも学習期間のデータで学習し、同じ評価データで予測しています(採用モデルは、そのうえで解答ごとにオンライン更新しています)。
採用モデルは、どの確率帯でも予測と実測がほぼ一致しており、難易度ラベルだけの場合と比べてずれが大幅に小さくなっています。一方、採用モデルでも回帰の係数を学習し直さずに固定すると、評価期間のあいだにユーザーが成長するぶん、予測が実際の正解率より低い側にずれていきました。解答ごとにオンライン更新する採用モデルではこのずれが自動的に補正され、キャリブレーション誤差(Expected Calibration Error、ECE)は約4分の1になりました。
プロダクトへのモデル適用と効果検証
モデルの精度が十分に出たとしても、それがプロダクトにどう活かされ、ユーザーにどのような価値を提供できるのか。技術を実際のプロダクトにどう組み込んでいくのかという問いに挑戦することが、2つ目のタスクでした。
学習計画の設計
そこでモデルが出す確率を使って、ユーザー一人ひとりの学習計画を立てる仕組みを作りました。ここでいう学習計画(ロードマップ)とは、どの単元のどの難しさの問題を、どの順番で1問ずつ出していくかを決めた、出題の並びのことです。なお本記事では、アプリが実際に毎日届ける問題を「オススメ」、この計画にもとづいて次の1問を選ぶことを「出題」と呼びます。この計画を作るために、次の3つをモデルの確率から計算します。
- ユーザーがゴールに届いたか
- ゴール到達までの必要問題数
- 次にどの難しさの問題を出すか
KTと計画の関係は、下の図のようなループになっています。KTは解答ごとに状態を更新して解ける確率を出し、その確率をどう使うかは計画側で決めます。図の「出題」は、解ける確率があらかじめ決めた値(図の「狙い」)に最も近い問題を選ぶというルールです。これは設計上の案で、現在の本番のオススメは別の仕組みで選ばれています。
KTと学習計画の関係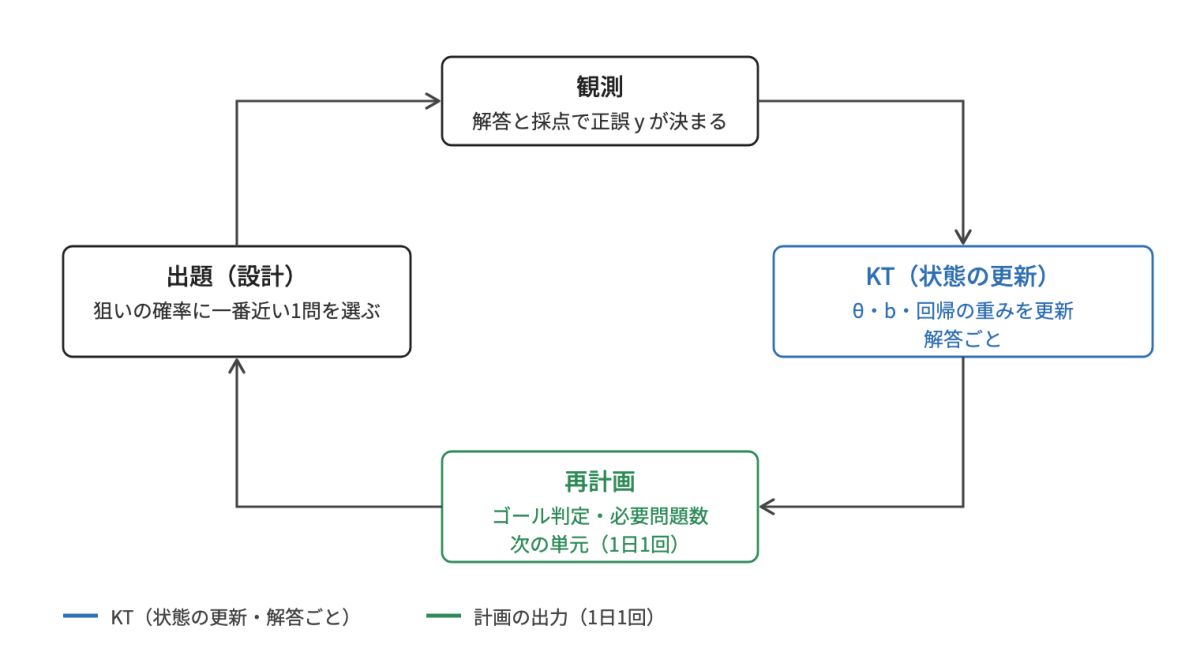
ゴールの定義
まず1の、「ユーザーがゴールに届いた」の定義から説明します。SIRUSでは、問題の難易度と志望校のレベルがいずれも1〜10の尺度で表現されており、ゴールを「志望校のレベルより1段下の難易度の問題で、20点以上を7割の確率で取れること」のように設定しました。たとえば志望校のレベルが9なら、難易度8の問題を7割解ければゴールです。
ただし、入試でどの単元がどれだけ出るかは大学によって違います。そこで、単元ごとの解ける確率を、その大学の過去問での出題割合で重み付けして平均したものを判定に使います。
$$ E(\theta) = \sum_{c} f_c \sigma(\theta - B_c) \geq 0.70 $$
ここで $f_c$ は志望校の過去問で単元 $c$ が占める出題割合(全単元で合計1)、$B_c$ は単元 $c$ のうちゴールの難易度(志望校レベルの1段下)の問題の問題レートの平均です。$\sigma(\theta - B_c)$ は、その単元の典型的な問題をいまの実力 $\theta$ で解ける確率で、モデルの第1段と同じ式です。
たとえば志望校の出題の6割が微分積分、4割が確率で、いまの実力で解ける確率がそれぞれ80%と50%なら、$E = 0.6 \times 0.8 + 0.4 \times 0.5 = 0.68$ となり、ゴールまであと少しです。「全単元で70%」ではなく、志望校がよく出す単元ほど重く見る定義になっています。
モデルの確率は「20点以上を取る確率」なので、ゴールの「20点以上を7割」と同じ量です。確率のキャリブレーションが取れているので、変換せずにそのまま判定に使えます。
ゴール到達までの必要問題数
ゴール到達までの必要問題数 $N$ は、判定式がちょうど0.70になる実力 $\theta_{\mathrm{goal}}$ と、いまの実力 $\theta$ の差を、1問あたりの伸び $\gamma$ で割って求めます。
$$ N = \left\lceil \frac{\theta_{\mathrm{goal}} - \theta}{\gamma} \right\rceil, \qquad E(\theta_{\mathrm{goal}}) = 0.70 $$
ゴール到達までの必要問題数の計算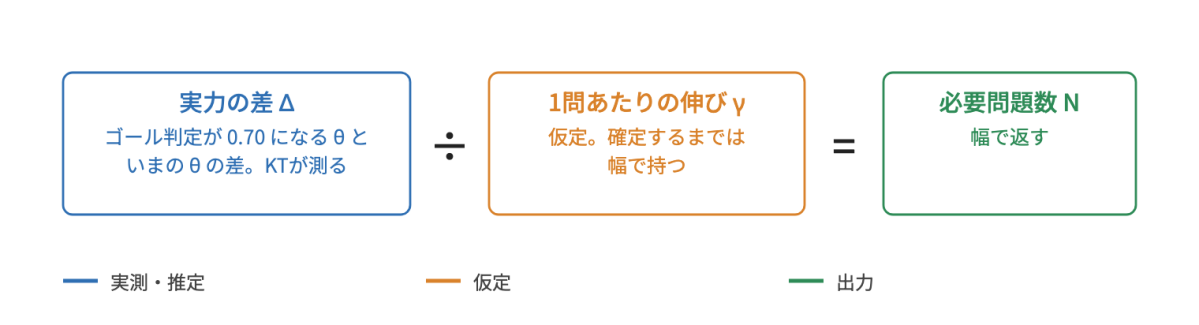
実力の差はモデルが測れますが、1問あたりの伸び $\gamma$ は、今回のデータ量では観測データから確かめられませんでした。観測ログから推定すると「中程度の難易度で練習すると1問あたり+0.035ほど伸びる」という値が出たものの、学習効果がゼロになるように作った合成データに同じ推定手順を通しても、ほぼ同じ+0.037が返ってきたためです(プラセボテスト)。そこで $\gamma$ は確定していない仮定として幅で持ち、必要問題数も必ず幅で返すようにしました。
計画の作り方(実験の設定)
どんな計画がよいかを比べるために、計画の候補を網羅的に作ってシミュレーションしました。流れは下の図の①〜③のとおりです。
計画の作り方の全体像(青い部分がタスク1のKTを使うところ)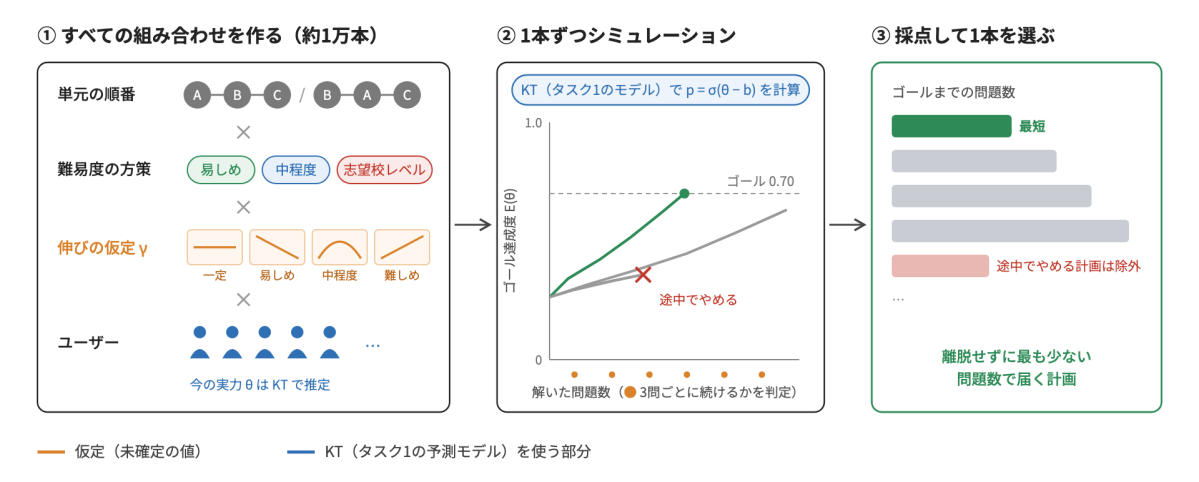
まず①で、単元に取り組む順番、出題する難易度の方策、1問あたりの伸びの仮定、ユーザーの4つの軸をすべて組み合わせ、約1万本の計画の候補を作ります。難易度の方策は、次に出す問題の難しさの決め方です。「易しめ」は解ける確率が0.82、「中程度」は0.60に最も近い難易度の問題を出し、「志望校レベル」はゴールの難易度の問題をそのまま出します。一部だけを選んで比べると、その選び方に自分の期待が入ってしまうためです。次に②で、候補を1本ずつシミュレーションし、ゴールに届くまでの問題数と、途中でやめてしまうかどうかを調べます。このとき、出題した問題を解ける確率 $p$ は、タスク1で作ったKTのモデルで計算します(図の青い部分)。ユーザーの出発点となる今の実力 $\theta$ も、KTで推定した値です。最後に③で、途中でやめずに最も少ない問題数でゴールに届く計画を選びます。
なお、網羅的に作るのはオフラインの検証のためです。本番では、その時点の実力から計画を1本だけ作り直します。実力 $\theta$ や問題の難しさ $b$ は解答ごとに更新し、今日のオススメや必要問題数は1日1回計算する設計です。
1本の計画のシミュレーションは、下の図のように進みます。
1本の計画のシミュレーションと採点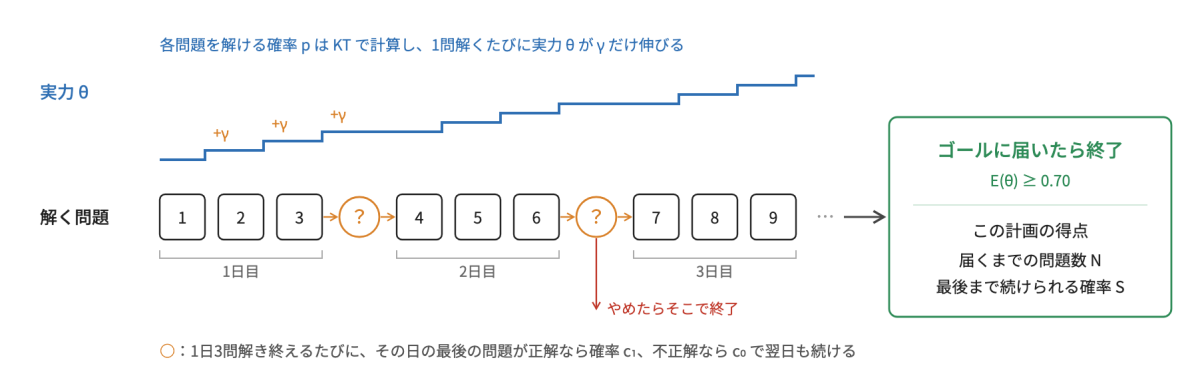
1問解くたびに、出題した問題の正解確率 $p_t = \sigma(\theta_t - b_t)$ を計算し、実力を仮定した伸びの分だけ進めます($\theta_{t+1} = \theta_t + \gamma$)。伸び $\gamma$ には、「難易度によらず一定」「易しめの問題で大きい」「中程度の問題で大きい」「難しめの問題で大きい」の4通りの仮定を置き、1問あたりの伸びの平均はそろえました。
途中でやめずに続けられるかは、実データから測った継続率で表しました。1日に3問解き終えるたびに、その日の最後の問題に正解していれば $c_1$、不正解なら $c_0$ の確率で翌日も続けるとします。$c_1$ と $c_0$ は、実際の解答ログで、その日の最後の解答が正解だったとき、不正解だったときに、次の日以降も解いていた割合です。計画の採点では、これを日ごとに掛け合わせて、ゴールまで続けられる確率 $S$ を求めます。
$$ S = \prod_{d=1}^{D} \left( p_d c_1 + (1 - p_d) c_0 \right) $$
ここで $p_d$ は $d$ 日目の最後の問題に正解する確率、$D$ はゴールに届くまでの日数です。各計画は、ゴールに届くまでの問題数と、この確率 $S$ で採点しました。
このシミュレーションでは、一度やめたユーザーは戻ってこない、全員が同じ続けやすさを持つ、毎日同じ数の問題を解く、という単純な前提を置いています。実際には戻ってくるユーザーもおり、かつ、毎日の活動量は変化し続けます。そのため、以下の結果では、到達率や問題数の値そのものではなく、どの計画のほうが早く届くか、計画の違いと途中でやめることのどちらの影響が大きいか、といった相対的な比較だけを結論にしています。
結果
約1万本の計画を採点した結果、わかったことは2つです。
1つ目は、伸びの仮定によって最短の計画が入れ替わることです。下の図は、同じユーザーに4つの計画を適用した結果を、伸びの仮定ごとに並べたものです。4つの計画は、難易度の方策ごとの3つ(易しめ、中程度中心、高難易度)と、中程度の難易度を出しながら、いま最も解ける確率が高い、まだゴールに届いていない単元から仕上げていく計画(中程度中心・得意な単元から)です。シミュレーションの結果を、ゴールに届くまでの問題数だけ残して直線で簡略化した模式図です。
伸びの仮定による最短の計画の入れ替わり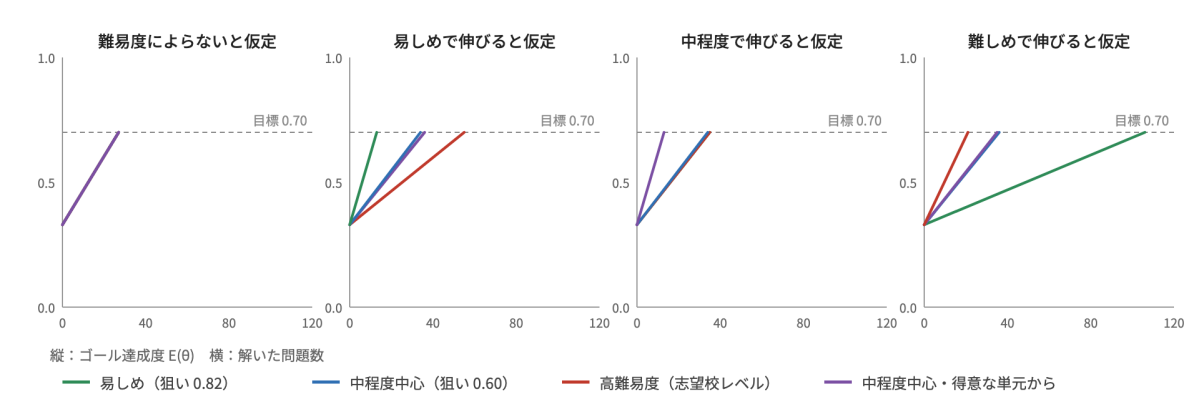
左端の「難易度によらない」と仮定した場合は4本の線が重なり、どの計画を選んでも同じ問題数でゴールに届きます。一方、「易しめで伸びる」と仮定した場合は易しめの計画が最短になり、「難しめで伸びる」と仮定した場合は高難易度の計画が最短になって、順位が逆転します。どの仮定が正しいかは今回のデータ量では確かめられないため、どの難易度で出題すべきかは、実際に出題を変えて測る必要があります。
2つ目は、継続の影響の大きさです。継続を組み込むと、計画を変えてもゴールに届くユーザーの割合(到達率)はほとんど変わらず、途中でやめることによる違いのほうが桁違いに大きくなりました。難しい問題ほど伸びると仮定した場合でも、難しい計画は有利になりませんでした。不正解が増えると継続も下がるため、学習効果と継続が逆向きに働くからです。継続の判定は毎日繰り返されるので、継続率の小さな差が積み重なって大きく効きます。
今後の展望
今回の取り組みでは、ユーザーの実力を測るモデルと、それを使って計画を立てる仕組みを、オフラインの検証で動くところまで作りました。もしまだ取り組むことができるのであれば、実装を実際のプロダクトの中で動かし、ユーザーの学習に届けたいと思いました。技術的に検証をしたいアプローチもまだ残っています。また、今回は予測精度を基準に、プロダクトにどう組み込めるかを検証しましたが、実際に組み込む段階では、精度だけではどのモデル・構成がよいかを決めきれない場面もあります。以下では、データ・モデルの面と評価の基準の面に分けて、その一部を紹介します。
データ・モデルの面では、次の3つを考えています。
- KTを本番で動かす: まずは予測を記録するだけの形で本番に載せ、オフラインで確かめた精度とキャリブレーションが実際の解答でも保たれるかを確かめます。そのうえで、今日のオススメを選ぶ仕組みに予測確率を渡し、ユーザーごとに難しさの合った問題が届くようにしていきたいと考えています。
- 1問あたりの伸びを測る: ゴール到達までの必要問題数の計算に使う伸びの値は、今回のデータ量では観測データから確かめられず、いまは幅を持った仮定として扱っています。実際に出題する難易度を変えて伸びを測ることができれば、「ゴール到達までの必要問題数」を幅ではなく1つの数字に近づけられ、どの難しさの問題を出すべきかも決められます。
- データの増加に合わせてモデルを見直す: ユーザーが解くほどデータが増え、実力の推定も計画も正確になっていきます。今回採用しなかった手法には、データがどれだけ増えたら再評価するかの条件を付けてあるので、データが増えたときに勾配ブースティングや深層学習を用いたKTへ移行できるかを確かめられます。継続のモデルにも、戻ってくるユーザーやユーザーごとの続けやすさの違いを入れ、より現実に近い計画の評価ができるようにしたいです。
評価の基準の面では、次のことを考えています。
- ユーザー体験も含めてモデルを比べる: プロダクトに組み込む上では精度がすべてではなく、UIでの見せ方など、ユーザー体験を優先してモデルの構成を変える判断もありえます。そのとき、構成を1つずつ変えたときの精度の差が分かっていれば、どれくらい精度を手放すことになるのかを比べたうえで判断でき、精度が大きく落ちるようなら、その要素を外しても精度を保てる別のモデルを考えることもできます。そのため、構成ごとの精度の差を残しながら、ユーザー体験という観点からもモデルの構成を比較検討したいです。
最終的には、ユーザーが1問解くたびに実力が測り直され、志望校のゴールまでの学習計画が自動で作り直される、そんな学習体験をプロダクトとして実現できればと思っています。
インターンシップを通じて
事業部からのフィードバック
インターン中は、メンターの方や事業部の方から、日々の進捗共有の中でたくさんの助言をいただきました。
たとえば、「評価指標を、事業部側に説明できる形で設計するところまで見据えたい」という助言をいただきました。研究では、log-lossのような指標でベンチマーク上の数字を比べれば、それで手法の良し悪しを議論できます。しかしプロダクトに組み込むモデルでは、その数字が出題をどう変えるのかが分からなければ、導入するかどうかを判断できません。そこで、「このモデルを使うと、どの問題を出すという判断になるか」という出題判断の単位でも評価しました。モデルの評価を、それを使って下す判断の単位まで落とし込むこと。これは、研究としての機械学習とプロダクトに組み込む機械学習の大きな違いだと感じました。
学びと経験
技術面
技術面での一番の学びは、今回のようにデータが少ない状況では、複雑なモデルよりも、事前知識を取り入れたシンプルなモデルのほうが予測精度が高かったということです。どんな場合にも当てはまるとは限りませんが、少なくとも今回のデータを使ったオフラインの評価では、1つずつ比べた結果がそう示していました。
その1つが、ユーザーの実力を単元ごとに分けず、1つの値で持つという判断です。単元別に実力を持つ構成も分け方を変えて何度か試しましたが、単元ごとに分けると1つの値あたりの観測が少なくなり、どれも1つで持つ場合より悪化しました。
もう1つの学びは、何をモデルに学習させ、何をモデルの外に置くかの切り分けです。1問あたりの伸びまでKTに予測させられないかと考え、まだ解いていない先の正誤をモデル自身の予測で埋めて実力を進めてみました。すると、実力を進めない場合よりも予測が悪化しました。実力の更新は、実際の正誤と予測した確率の差 $y - P_1$ の分だけ動かす仕組みなので、正誤の代わりに予測した確率そのものを入れると、差はゼロになり実力は動きません。予測した確率から正誤をサンプリングして入れると、実力は上下に動きますが、その期待値はゼロで、ノイズ(分散)が増えるだけです。どちらの場合も、新しい情報が何も入っていないからです。実力は、実際に解いて正誤を見てはじめて正しく動きます。何でもモデルに取り込めば良くなるわけではありません。データから学べるもの(いまの実力)はモデルに任せ、今回のデータからは決められないもの(この先の伸び)は、外から仮定として与えたほうがよい場合もあります。そこで、KTは確率を出すことだけを担当し、伸びの仮定は計画側に置くと役割を分けました。
技術以外の経験
技術以外で印象に残っているのは、新規プロダクトの開発のスピード感です。参加する前は、機械学習のプロジェクトは研究のようにじっくり進むものだと思っていました。実際には、新規事業では短い期間で結果を出すことが求められ、KTの手法の選定から実装までを1週間単位で進めていきました。そのスピードの中でも、検証をきちんと回しながら機械学習をプロダクトに組み込めると体感できたことは、大きな発見でした。
また、タスクはエンジニアだけで閉じず、ビジネスサイドの方とも議論しながら進めることができました。社内のさまざまな方と話す機会も作っていただき、技術そのものを突き詰めている方もいれば、技術を使ってプロダクトを作ることに軸を置いている方もいて、関わり方は人によってさまざまでした。こうした経験を通じて、私は、技術とビジネスの両方の視点から、プロダクト開発に取り組んでいきたいという思いが強くなりました。
おわりに
DeNAでのサマーインターンシップは、私にとって非常に充実した、学びの多い期間でした。このインターンシップを通じて、機械学習モデルの開発から、その予測をどう評価するか、そしてプロダクトにどう組み込んでいくかまでの一貫したプロセスを1つのテーマとして通して取り組むことができました。さらに、それを短い期間の中で、問いを立てて実験し、その結果をもとに次の判断を決める、というサイクルを何度も回しながら進められたことは、大きな経験になりました。
とくに、少ないデータという制約の中で、試行錯誤を重ねて精度を改善できたこと、そしてモデルの予測がプロダクトの判断につながっていく仕事の面白さを肌で感じることができました。データサイエンスがプロダクト全体にどう関わるべきかという、より深い視点を得られたと感じています。
このインターンシップ期間中に支えてくださったメンターの皆様には、心より感謝を申し上げます。本記事が、機械学習に興味がある方や、データを通じてプロダクトを動かしてみたいと思っている学生の皆さんの参考になれば幸いです。最後までお読みいただき、ありがとうございました。

最後まで読んでいただき、ありがとうございます!
この記事をシェアしていただける方はこちらからお願いします。