


はじめに
2026年度のDeNA AIスペシャリストサマーインターンシップに参加した金原優太です。4週間のインターンでは、英語リスニングプロダクト「キコエルート」のKnowledge Tracing(知識追跡、以下KT)の改善に取り組みました。本記事では、リスニング能力をどうモデル化したか、合成データで何を検証できたかについて紹介します。
※この記事はインターンに取り組んでいた 2026年9月 時点のもので、現在のプロダクトには変更された箇所があります。
自己紹介
京都大学大学院情報学研究科データ科学コースに所属しています。情報論的学習分野の研究室に所属し、ポーカーを題材にして機械学習や応用確率論、計算ゲーム理論の研究をしています。
プロダクト概要
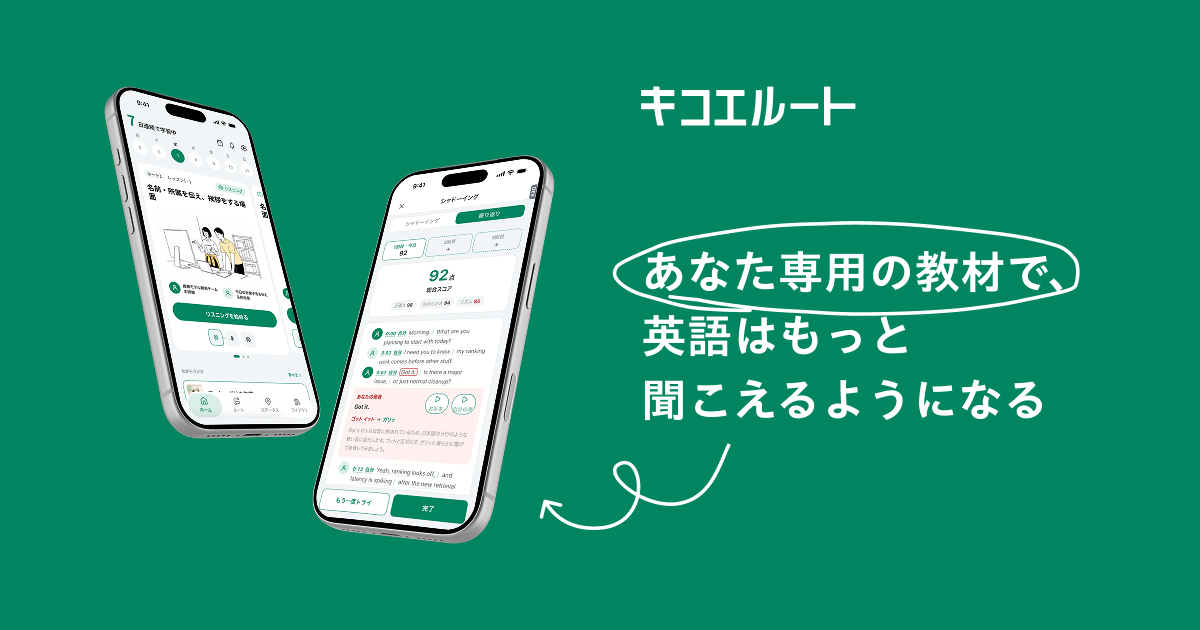
キコエルート は、学習者の目標に合わせた教材で英語の聞き取りを練習するサービスです。会話を聞くレッスン、シャドーイング、学んだ表現を確かめるミニテストがあります。
キコエルートで取り組んだ課題
学習者に適した問題を出したり、苦手な分野を示したりするには、回答履歴から現在の能力を推定する必要があります。その役割を担うのがKTです。
既存の実装にはBayesian Knowledge Tracing(BKT)が使われていました。BKTは知識要素(Knowledge Component、以下KC)ごとに「習得済み」「未習得」の状態を推定します。キコエルートでは、音韻・語彙・フレーズに関する27個のKCが設定されていました。ただ、英語の聞き取りでは、ある知識が別の弱さを補うことがあります。KCを個別に扱う方法では、その相互作用を表現しにくいと考えました。
リスニング能力を階層として捉える
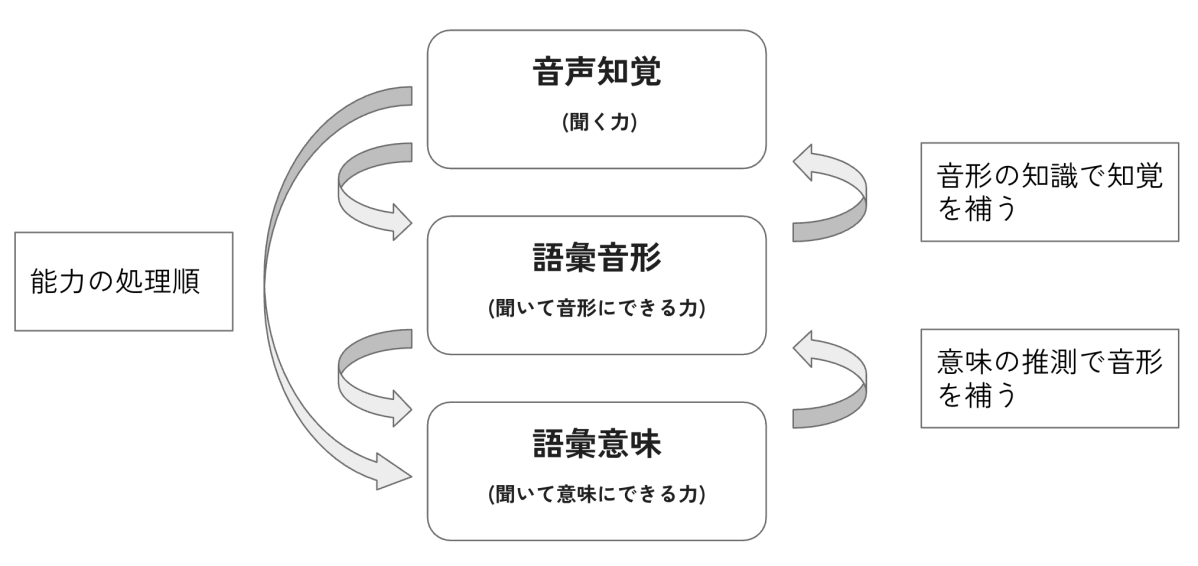
Field のリスニング過程に関する議論を参考に、今回の取り組みでは、英語の聞き取りに関わる能力を「音声知覚」「語彙音形」「語彙意味」の3つに整理しました1。たとえば音声知覚が不十分でも、知っている単語の音から聞き取りを補える場合があります。そこで、この3つの能力と相互作用を表現するKTモデルを検討しました。
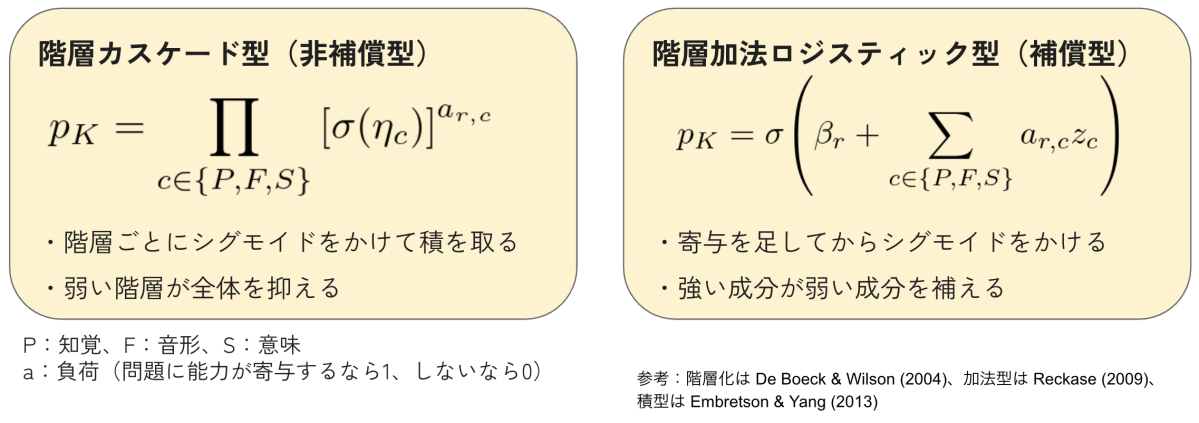
提案したのは、各能力の寄与を足し合わせて正答確率を求める「階層加法型」と、段階ごとの確率を掛け合わせる「階層カスケード型」です。どちらも回答を観測するたびに能力の推定値を更新します。違いとしては、加法型では得意な能力が苦手な能力を補える一方、カスケード型では、どこかの段階が弱いと全体の正答確率も下がります。能力の階層化は説明的項目反応モデル2、加法型は多次元項目反応理論3、カスケード型は多成分潜在特性モデル4を参考にしました。両方を試すことで、リスニングの能力間の関係を1つの仮定に決め打ちせずに比較しました。
合成データで予測性能を比較する
検討時点では十分な実回答データがなかったため、学習者の能力の変化と回答履歴を模した合成データで評価しました。初期能力や忘却の条件として、標準的な学習者、音声知覚は弱いが意味知識は強い学習者、忘却が速い学習者の3パターンを想定し、それぞれについて加法型とカスケード型の2通りのデータ生成方法を用意しました。
実験パイプライン
まず、1条件につき300人の学習者、全員に共通する24フレーズ、0・1・3・7・14・21日目の6時点を設定しました。学習者の傾向に応じて初期能力や忘却のしやすさを変え、各人の能力の推移を生成します。その能力から各問題の正答確率を求め、確率にしたがって正解・不正解を発生させました。このモデル比較では、データ生成のばらつきを確認するため、乱数シードを10通り変えて同じ実験を繰り返しています。
次に、各学習者の回答履歴を時系列で分け、0・1・3・7日目を学習用、14日目を検証用、21日目をテスト用としました。学習用データでモデルのパラメータや能力を推定し、検証用・テスト用では共有パラメータを固定します。各回答を見る前に正答確率を予測し、実際の正誤を観測したあとで推定能力を更新して、次の問題へ進みます。テストでは正誤予測をLogLossやROC-AUCで評価し、能力推定には真値とのRMSEを主指標、Pearson相関を補助指標として用いました。
回答予測の比較結果
以下は、3パターンそれぞれのテストデータにおけるLogLossを、10シードで平均した結果です。値が小さいほど正誤の予測が良いことを示します。
| データ生成方法 | 学習者の条件 | BKT | 階層加法型 | 階層カスケード型 |
|---|---|---|---|---|
| 加法型 | 標準 | 0.7495 | 0.5743 | 0.5922 |
| 加法型 | 音声知覚が弱く意味知識が強い | 0.7794 | 0.5831 | 0.6211 |
| 加法型 | 忘却が速い | 0.7470 | 0.5761 | 0.5923 |
| カスケード型 | 標準 | 0.6815 | 0.6089 | 0.5949 |
| カスケード型 | 音声知覚が弱く意味知識が強い | 0.6936 | 0.6018 | 0.5907 |
| カスケード型 | 忘却が速い | 0.6803 | 0.6078 | 0.5934 |
3パターンすべてで、提案した2モデルのLogLossはBKTより低くなりました。加法型の生成データでは階層加法型、カスケード型の生成データでは階層カスケード型の予測がもっとも良い結果でした。
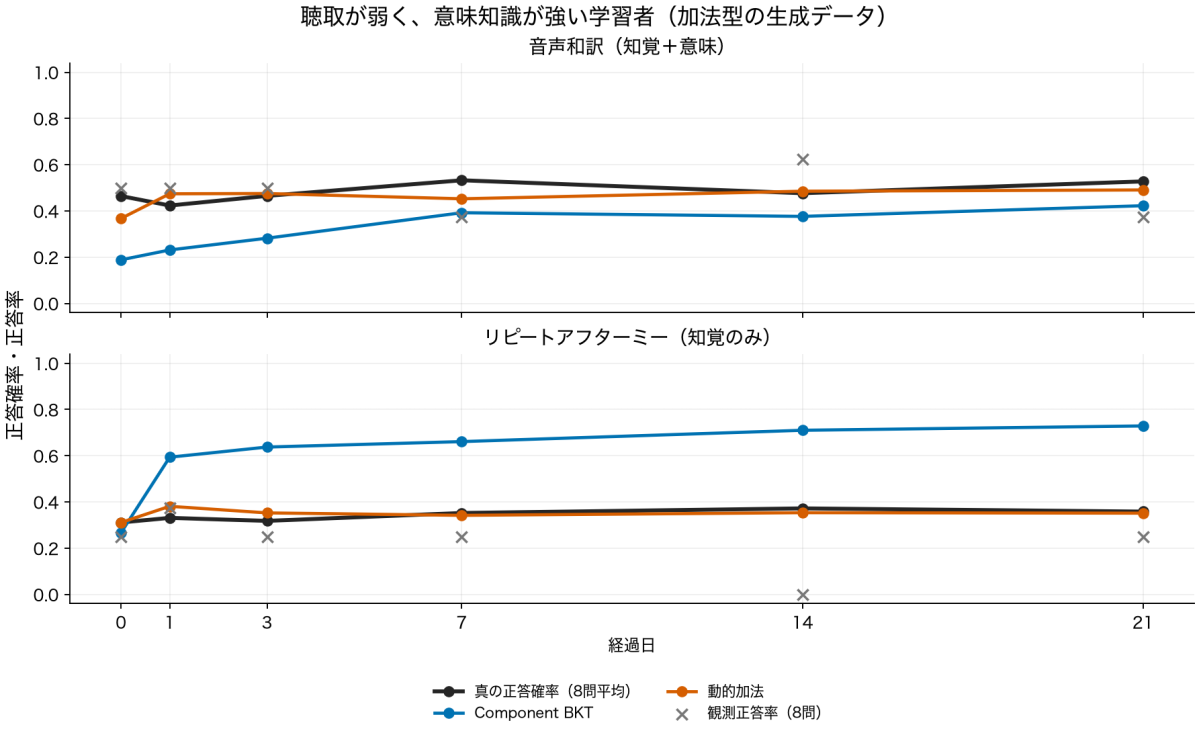
音声知覚が弱く意味知識が強い条件では、補助評価として1人の予測推移も確認しました。音声和訳は聞こえた単語やフレーズを和訳して答える問題、リピートアフターミーは聞こえた単語やフレーズをそのまま繰り返す問題です。音声和訳ではBKTが真の正答確率を低めに、リピートアフターミーでは1日目以降に高めに予測しました。階層加法型は両課題で真値に比較的近い推移でした。
能力推定の比較結果
標準条件では、推定した能力が真値にどれだけ近いかを評価しました。能力推定の主指標には、学習データで尺度を合わせた推定値と真値のRMSEを採用しました。補助指標として、真値と推定値の線形な対応を表すPearson相関も確認しました。次の表は異なるデータ生成方法において、テストデータにおけるRMSEとPearson相関の10シード平均です。
加法型の生成データ
RMSE(小さいほど良い):
| モデル | 音声知覚 | 音形 | 意味 |
|---|---|---|---|
| BKT | 1.910 | 2.192 | 1.879 |
| 階層加法型 | 0.366 | 0.860 | 0.917 |
| 階層カスケード型 | 0.358 | 0.859 | 0.943 |
Pearson相関(大きいほど良い):
| モデル | 音声知覚 | 音形 | 意味 |
|---|---|---|---|
| BKT | 0.839 | 0.288 | 0.463 |
| 階層加法型 | 0.943 | 0.173 | 0.366 |
| 階層カスケード型 | 0.940 | 0.166 | 0.291 |
カスケード型の生成データ
RMSE(小さいほど良い):
| モデル | 音声知覚 | 音形 | 意味 |
|---|---|---|---|
| BKT | 1.979 | 1.845 | 1.801 |
| 階層加法型 | 0.445 | 0.879 | 0.981 |
| 階層カスケード型 | 0.386 | 0.860 | 0.966 |
Pearson相関(大きいほど良い):
| モデル | 音声知覚 | 音形 | 意味 |
|---|---|---|---|
| BKT | 0.856 | 0.099 | 0.313 |
| 階層加法型 | 0.922 | 0.053 | 0.194 |
| 階層カスケード型 | 0.931 | 0.058 | 0.206 |
音声知覚・音形・意味のすべてで、2種類の生成方法のどちらでも提案した2モデルのRMSEがBKTより小さくなりました。
音声知覚の相関は提案モデルでも改善しましたが、音形・意味の相関はBKTより低く、これらの推定値と真値の対応には課題が残りました。また、RMSEはモデルごとに異なる能力表現を学習データで真値に対応付けた値です。RMSEの改善だけで個別の能力を正確に追跡できるとは結論づけられず、補助指標の相関と併せて解釈する必要があります。
「わからない」を回答として扱う
もう1つ検討したのが、3択問題に「わからない」を加えることです。正解・不正解だけを観測すると、理解して正解した場合と当てずっぽうで正解した場合を見分けにくくなります。ヒントを使う行動と知識状態を合わせてモデル化した研究5や、選んだ選択肢を分析する研究6を参考に、正誤以外の情報にも注目しました。自信がないときに「わからない」を選べれば、能力推定の手がかりが増えるのではないかと考えました。
そこで、答えがわからない学習者が「わからない」を選ぶ割合を0%、50%、100%と変えた合成データを作り、将来の回答予測を比較しました。この「わからない」実験では、乱数シードを5通りで変えて評価しました。階層加法型では「わからない」を選ぶ割合が高いほど、テストデータのLogLossが低下する傾向が見られました。音形と意味の能力推定についても、真値との相関が改善しました。一方、階層カスケード型の予測改善は小さく、効果はモデルやデータの条件によって異なります。
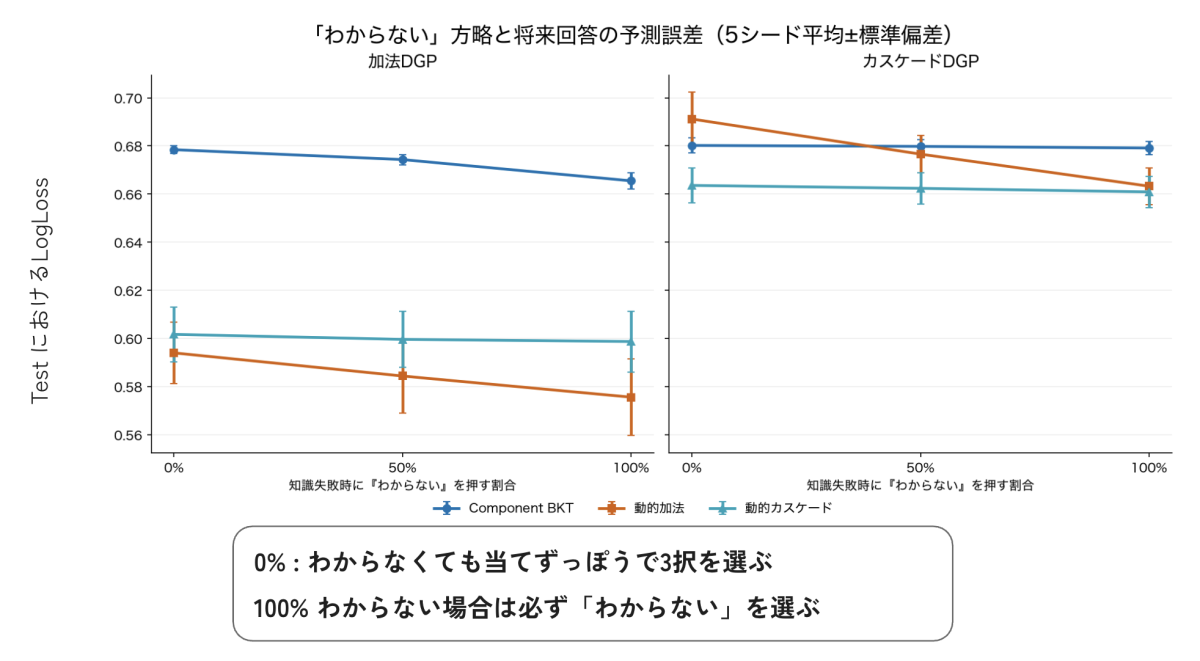
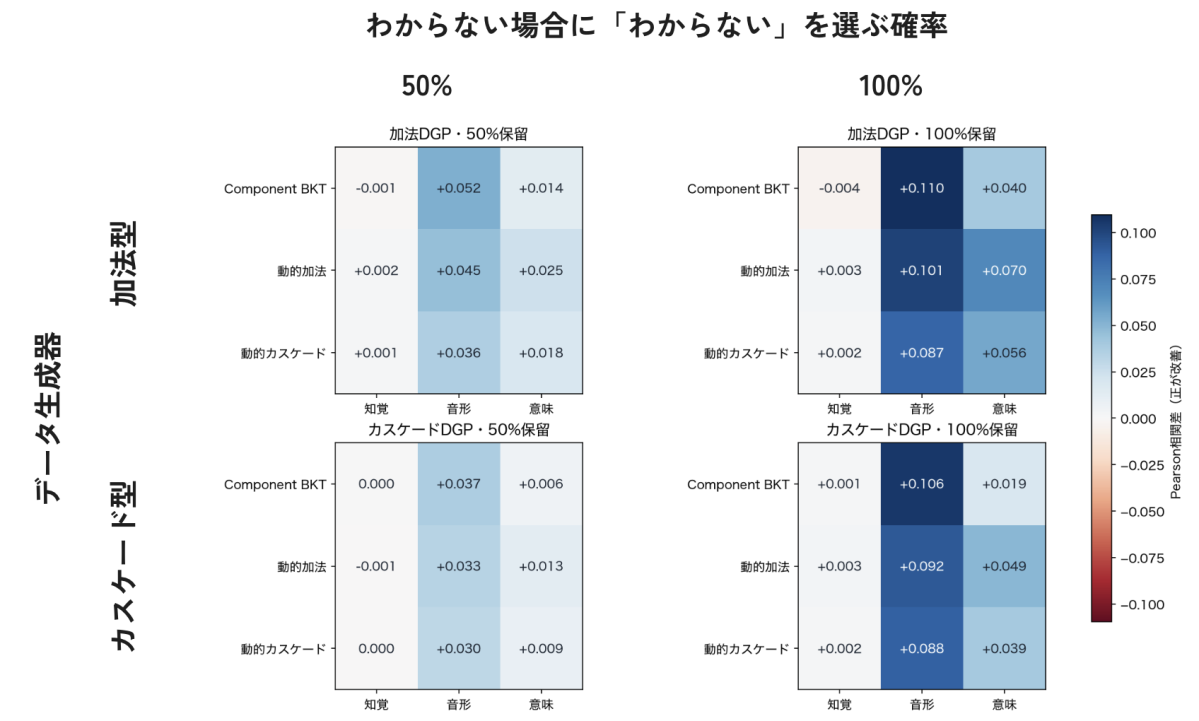
合成実験では、学習者が知識不足を正しく自覚し、そのときに設定した確率で「わからない」を選ぶと仮定しました。モデルもその選択割合を既知として使い、テストでは全条件で「わからない」を選べない同じ3択問題への回答を予測しています。 この選択肢は、インターン期間中にプロダクトにも反映していただきました。実際の学習者の選び方に個人差がある場合の予測精度や、ユーザー体験への効果は今後の検証が必要です。
まとめと今後の課題
今回の検証では、リスニングを音声知覚・語彙音形・語彙意味の階層として扱うモデルが、加法型・カスケード型の合成データ上でBKTより良い予測結果を示しました。標準条件では能力値のRMSEも小さくなりましたが、音形・意味の相関には改善が見られませんでした。また、理想化した条件では、「わからない」という回答を得ることで能力推定を改善できる可能性も確認しました。
今後の課題としては、異なる傾向を持つ学習者が混在する場合や、「わからない」の選び方に個人差がある場合等の調査が挙げられます。もっとも重要なのは、実際に蓄積される回答データで予測精度と学習体験への効果を確かめることです。
おわりに
データがまだ十分にない段階でモデルを提案するのは難しい課題でしたが、仮説を立て、検証できる形に落とし込む過程は貴重な経験でした。プロダクトのリリースに向けたQAにも参加し、自分の提案が素早く反映される現場を見られたことが印象に残っています。メンターの吉田さん、POの森さんをはじめ、関わってくださった皆さんに感謝します。
参考文献
-
Field, J. (2008). Listening in the Language Classroom . Cambridge University Press. ↩︎
-
De Boeck, P., & Wilson, M. (Eds.). (2004). Explanatory Item Response Models . Springer. ↩︎
-
Reckase, M. D. (2009). Multidimensional Item Response Theory . Springer. ↩︎
-
Embretson, S. E., & Yang, X. (2013). A Multicomponent Latent Trait Model for Diagnosis . Psychometrika, 78, 14–36. ↩︎
-
Chaudhry, R., Singh, H., Dogga, P., & Saini, S. K. (2018). Modeling hint-taking behavior and knowledge state of students with multi-task learning . Proc. EDM 2018. ↩︎
-
Ghosh, A., Raspat, J., & Lan, A. (2021). Option tracing: Beyond correctness analysis in knowledge tracing . Proc. AIED 2021 (LNCS 12748), 137–149. ↩︎

最後まで読んでいただき、ありがとうございます!
この記事をシェアしていただける方はこちらからお願いします。