


はじめに
こんにちは。IT本部AI・データ戦略統括部所属の黄です。
DeNAのIT本部では、QA業務の効率化を目指して「DAAQ(DeNA AI Advanced Quality)」というシステムの開発・運用を進めています。本記事では、DAAQの中でも中心的な取り組みであるテスト設計支援領域の全社展開までの歩みと、それを支えるシステムアーキテクチャを紹介します。
後半では、現場導入後に直面した課題に対してどのように対応し、実務で利用できるレベルへ引き上げたのか、その舞台裏をお伝えします。
DAAQ(DeNA AI Advanced Quality)とは
ソフトウェアテストの現場では、仕様書や設計資料を読み解き、テスト観点を洗い出して具体的なテストケースへ落とし込む作業に多くの工数が割かれています。また、作成されるテストの品質が対象ドメインの知識や担当者の経験に依存しやすい点も長年の課題でした。
DAAQは、仕様書、画面設計書、プロジェクト固有の仕様、過去のテストナレッジなどを入力とし、機能テスト、表示テスト、シナリオテストといった多様なテスト設計ワークフローを提供するシステムです。単にLLMへ一度問い合わせて終わりにするのではなく、テスト設計に必要な工程を複数のステップに分割して順次処理することで、現場でそのまま編集・活用できる成果物を生成します。このほか、仕様書自体の不備や抜け漏れを早期に検出する仕様書インスペクション機能も備えています。
DAAQの概要は 公式サイト でも紹介しています。また、開発の背景となった品質管理部門のAI化戦略については、ブログ記事 「DeNA 品質管理部門が挑むAI化戦略」 をご覧ください。
DAAQテスト設計支援領域の全社展開と得られた成果
DAAQの開発は、QA業務の中でもとくに工数シェアの大きいテスト設計を効率化することからスタートしました。初期フェーズでは少数のプロジェクトで試用しながらプロトタイプ検証を重ね、対象とするテスト種別やワークフローを段階的に拡大していきました。
全社展開を進める上で重視したのは、ツールを作って配布することではなく、現場のQA担当者が日々の実務で使い続けられる体験を作ることです。現場から得られたフィードバックを即座にワークフローや操作感へ反映し、導入と改善のサイクルを高速に回してきました。
現場での利用と改善を重ねた結果、 DAAQ公式サイト で公開しているとおり、社内ではテスト設計工数を平均約50%削減しました。さらに、2026年3月時点で、生成されたテストのうち95%が修正不要(そのまま実務で利用可能)と判定されたプロジェクトや、仕様書インスペクション機能で指摘事項の92%が有効と評価されたプロジェクトも確認されています。
DAAQがもたらした価値は、単なる工数削減にとどまりません。QA担当者の役割が「ゼロからテストを書き起こす作業」から「AIが生成したテスト成果物を確認し、必要な判断や調整を加える役割」へとシフトしたことです。これにより、リスク分析やエッジケースの検討など、人間にしかできない品質判断業務へより多くの時間を充てられるようになりました。
DAAQのテスト設計を支える全体アーキテクチャ
DAAQの全体アーキテクチャ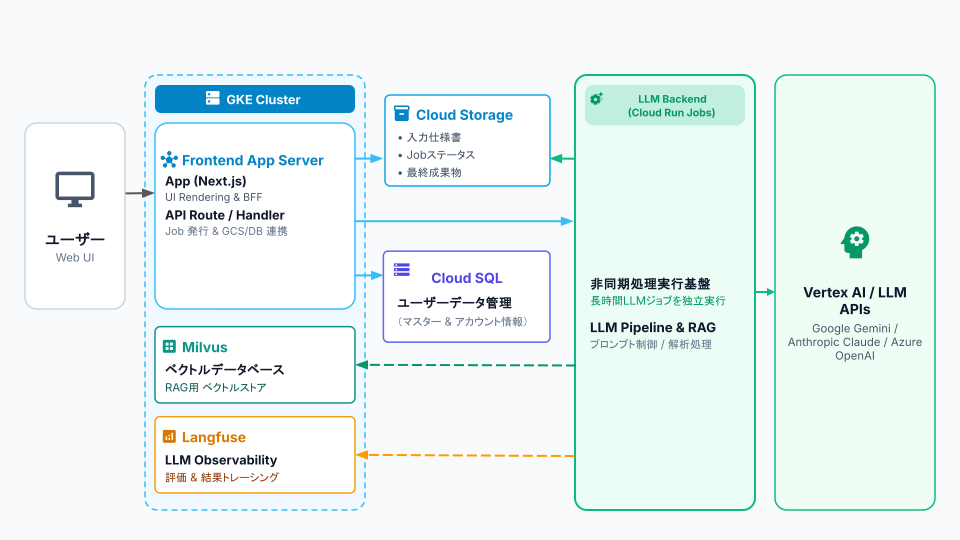
DAAQテスト設計領域のシステム構成は、ユーザーが操作するフロントエンド(図中のFrontend App)、各種ファイルを保持するCloud Storage、ユーザー情報や設定データを管理するCloud SQL、そしてAIによるテスト設計処理を担うLLM Backendが中核となっています。さらに、RAG基盤としてベクトルデータベースのMilvus、LLM処理の監視・評価基盤として Langfuse を組み合わせています。
フロントエンド、Milvus、Langfuseは Google Kubernetes Engine(GKE) クラスター上で稼働し、長時間の処理を担うLLM Backendは Cloud Run Jobs の非同期ジョブとして実行します。LLM Backendでは、用途に応じてVertex AI経由でGeminiやClaudeを、Azure OpenAI経由でOpenAIのモデルを利用します。
LLM BackendにCloud Run Jobsを選定したのは、HTTPリクエストの受付を前提とせず、開始から完了まで実行する長時間の非同期処理に適しているためです。Cloud Runのサービスとして実行する場合と比べて処理をジョブ単位で管理しやすく、GKE Jobと比べてクラスターのリソース管理から切り離して、実行時に必要なCPUやメモリを確保できます。
フロントエンド
フロントエンドでは、入力資料の登録、テスト設計の実行、進捗の確認、生成された成果物の確認と編集まで、一連の操作を行えます。AIの出力をそのまま正解とせず、ユーザーであるQA担当者が各ステップの成果物を確認し、必要に応じて編集や再実行ができるようにしています。
ユーザーが処理を実行すると、フロントエンドから必要な入力情報を連携し、LLM Backendへ実行を要求します。時間のかかる処理はLLM Backendで非同期に進み、フロントエンドには処理の進捗と生成結果が反映されます。
LLM Backend
AIを用いたテスト設計処理のうち、時間のかかるワークフローはCloud Run Jobs上のLLM Backendで非同期ジョブとして実行します。フロントエンドから受け付けた入力資料とジョブ情報はCloud Storageへ保存され、LLM BackendがLLM処理パイプラインとRAGを組み合わせて処理します。ジョブの進行ステータスと最終成果物もCloud Storageへ保存され、フロントエンドから参照されます。
LLM Backend内部では、テスト種別ごとに定義されたワークフローに沿って処理が多段ステップで進みます。たとえば「仕様情報の抽出 → テスト観点の洗い出し → テストケースの作成」のように、QA担当者がテスト設計時に行う思考プロセスをステップとしてワークフローに落とし込んでいます。単一のプロンプトですべてを生成させるのではなく、ステップごとに入出力を構造化し、前段の成果物やRAGで取得した情報を次の処理へコンテキストとして引き渡すことで、複雑なテストケースでも精度の崩れにくい設計にしています。
RAG基盤(Milvus)
入力資料やテストナレッジはベクトル化してMilvusへ保存します。LLM Backendは、RAGを利用するステップで必要な情報をMilvusから検索し、コンテキストとしてLLMへ渡します。これにより、大量の資料から処理対象に関連する情報を選び、テスト設計に活用できます。
Milvusを選定した主な理由は、GKE環境との親和性と、データを保存するストレージ層と検索などを担うコンピュート層を分離した構成による拡張性です。 Milvusのアーキテクチャ はステートレスなワーカーノードを個別にスケールアウトできるため、データ量や検索負荷の増加に応じて、必要な処理能力を拡張できます。
加えて、 複数の粒度で構成できるマルチテナンシー と RBACによるアクセス制御 を備えており、プロジェクトごとのデータ分離や権限管理を堅牢に設計できる点も、選定理由となりました。
監視・評価基盤(Langfuse)
Langfuseでは、LLM Backendが実行したLLM処理のリクエストやレスポンスをトレースし、実行状況を可視化します。プロンプトやモデルを変更した際の結果を追跡し、出力精度や処理コストを評価・改善するために活用しています。
現場導入で見えた課題と対応
AIを用いたテスト設計は、開発で期待通りの出力が得られただけでは現場に定着しません。プロジェクトごとに資料の構成や求めるテストの粒度が異なる上、出力が高品質であっても、処理に時間やコストがかかりすぎれば業務には定着しません。
DAAQでは、現場運用で見えてきた課題を「改善サイクル」「精度」「速度・コスト」の3点から整理し、対応を進めてきました。
現場フィードバックを起点とした改善サイクル
DAAQのテスト設計領域が全社展開に至る道のりは、最初から順風満帆だったわけではありません。実際のプロジェクトに導入すると、「この仕様書フォーマットだと抜け漏れが生じる」といった声や、既存の仕様だけでは想定ほど工数削減につながらない現実が浮き彫りになりました。
そこで、開発チームとQA担当者が密に連携し、影響範囲と見込まれる工数削減効果を元に、改善の優先度を決定しました。大きな改修を一度にリリースするのではなく、検証可能な最小単位で素早く実装して現場へ届け、実業務で評価してもらうサイクルを徹底しました。
要件を詳細に整理すると、LLMによる判断が必要だと想定していた処理でも、ルールベースの処理で十分な場合や、複数件のデータをまとめて処理しても必要な精度を維持できるケースがありました。LLMの利用を前提に設計を固定せず、出力精度、処理速度、コストのバランスに応じて処理フローそのものを見直すアプローチが定着の鍵となりました。
また、改善サイクルを継続するため、課題や導入先の増加に応じて拡張できる開発体制を模索しました。不確実な要件を最初から作り込まず、仮説を小さく実装して早期に現場で検証する進め方を取りました。
出力精度の改善
LLMの出力精度は、モデルやプロンプトだけで決まるものではありません。入力ファイルの種類や内容、情報を抽出・分割する方法、LLMへ渡すコンテキストなど、複数の要素が影響します。
DAAQでは、テスト種別ごとに処理を複数のステップへ分け、各ステップに適したLLM処理パイプラインを構築しています。入力資料、プロジェクト固有の情報、テストナレッジを役割ごとに整理し、必要に応じてRAGで検索した情報も含め、各ステップに必要なデータをコンテキストとして渡します。
また、一度構築した処理ロジックを固定化せず、実プロジェクトの入力データを用いて変更前後の出力を継続的に評価しています。精度向上が確認できた場合は、ファイルの処理方法、プロンプト、使用モデル、処理パイプラインの構成などを見直し、モデルと周辺技術の進化を継続的に取り込んでいます。
処理速度とコストの改善
DAAQのテスト設計では、仕様書や画面設計書などの入力資料に加え、そこから抽出した画面要素やテスト観点など、多くのデータを処理します。対象となる機能や画面が増えるほどLLMへ渡す処理単位も増えるため、すべてを直列に実行すると待ち時間が長くなり、業務フローを妨げてしまいます。
そこで、処理を互いに依存しない単位へ分割し、I/O待ちが発生するLLM呼び出しを含む一連の処理を可能な限り非同期で実装しました。複数の非同期処理方式を検証した結果、現在はLangChainの
abatch_as_completed
を使った並行実行を採用しています。
以下は、DAAQで採用している非同期処理の一例として、テスト対象ごとに構築したLangChainのチェーンを並行実行するコードを簡略化したものです。
resolved = [None] * len(targets)

async for index, result in chain.abatch_as_completed(
    targets,
    config={"max_concurrency": MAX_CONCURRENCY},
    return_exceptions=True,
):
    if isinstance(result, Exception):
        raise result
    resolved[index] = result
abatch_as_completed を使うと、時間のかかる処理の完了を待つ間に、他の処理を並行して進められます。結果は完了順に返されるため、返されたインデックスを使って入力順に格納しています。また、LLM APIのレートリミットやメモリ使用量を考慮し、max_concurrency で同時実行数の上限を設けています。
並行実行に加えて、前述の改善サイクルを通じて処理フローを見直し、ルールベースへの置き換えや複数件のデータをまとめた処理によってLLMの呼び出し回数を減らすなど、ユースケースごとに速度とコストを最適化しています。
まとめと今後の展望
DAAQのテスト設計領域を全社展開することで、QA担当者がテストをゼロから設計する負担を減らし、AIが生成した成果物を起点に、より短い時間で実務に使えるテスト成果物を作成できるようになりました。
今後は、社内での導入をさらに広げるとともに、各現場の資料やルール、テストナレッジを生かせる仕組みを強化します。テスト設計の効率化にとどまらず、QA担当者がリスク分析や品質判断といった専門性の高い業務へ集中できる環境を整え、QA活動全体の価値を高めていく方針です。
さらに、社内の多様なプロジェクトで培ったこれらのアーキテクチャや現場導入の知見を洗練させ、社外のQA現場にも提供できるプロダクトへの発展を目指します。


最後まで読んでいただき、ありがとうございます!
この記事をシェアしていただける方はこちらからお願いします。