


メンバーの立ち上げもAI Nativeに
チームに人が入るたびに同じ説明を繰り返していませんか?散らばった資料から使えそうなものを探してませんか?重い腰を上げて作成したオンボーディング資料集、もう古くなってませんか?
本記事では部のオンボーディングをGitHubリポジトリに集約し、Claude Codeを伴走させる仕組みを作った話を紹介します。
とくに以下のような方にオススメです。
- オンボーディング資料が更新されず、実態と食い違っているのを知りつつ放置している
- 新規メンバーの立ち上がりが、本人のスキルによって大きくブレる
- AIエージェントに実務を任せてみたいが、どこまで任せられるのか掴めていない
- 社内ドキュメントとAIエージェントを繋ぐときのリアルな落とし穴を知りたい
はじめに
お久しぶりです、AIオールイン 入社(25卒)の u-tan こと勝野侑馬です。
前回の記事
では、新卒研修のスクラム開発をAIでハックした話を書きました。あれから配属を経て、いまはヘルスケア領域のデータサイエンス部でデータ分析やR&Dやあれやこれやとやっております。
福岡から上京してきてはや一年、あまりにもダンジョンな街「渋谷」にも慣れてきた4月某日。新卒の配属に向けてジョブディスクリプションを書いたりアンケートを作成したりと準備を進めているとき、配属される新卒の受け入れ担当になる予定だった僕はふと思いました。
「新卒の疑問に答えられる自信がないな。Claude Codeに聞いてくれ。」
とてもヤバい先輩ですね。流石にこれは冗談なんですけど、疑問に思ったことをその場でClaude Codeに聞けると新規メンバー視点で楽だろうなとは思いました。そこで、
「エージェントが伴走するオンボーディングとかあったら便利そうだし面白そう!!」
という思いつきを上長に説明したところ、「面白そうだしやって良し」との許可をいただいたのでノリノリで7月に配属されてくる新卒の喜ぶ顔を想像しながらせっせと作って迎えた7月。。。
新卒は配属されませんでした(泣)
しかし悲しみに暮れる間もなく、8月に新たなメンバーが仲間入りすると言う話を聞きつけ、これはチャンス到来とばかりにドキドキしますが、実際に利用していただきました。
そしてこの度、今回のブログで紹介するリポジトリでのオンボーディングが無事完了しましたので知見の棚卸しとしてブログに残しました。
本記事では、設計で一番悩んだ「本文を持たせない」という判断と、実際に中途入社の方に1か月使ってもらってわかったことを中心にお話しします。
コトのはじまり
「これ、次どこ見ればいいんですか」問題
部のオンボーディングには、受け入れ担当になる前から見えている課題が3つありました。
これまでは受け入れ担当が新規メンバーに伴走する形で実施しておりそれでも良かったのですが、これは先輩たちのレスが速くシゴデキだからそれで良かっただけで、今から話す課題を解決すれば形はどうあれもっと楽にお互いwinwinな状態を目指せると思っていました。
1つ目は、情報の散らばりです。
手順はConfluence、データ仕様書はGoogle Drive、項目一覧と進捗はスプレッドシート、質問はSlack。中にはものすごく古い資料も混ざっていました。
そのため、新規メンバーは欲しい情報のために複数のツールを横断し、それでも分からなければ受け入れ担当に聞くことになります。
2つ目は、進み方が個人のスキルに依存することです。
私が所属しているのはデータアナリストのチームで、統計や分析には強くても、エンジニアリングにはあまり明るくないメンバーが少なくありません。にもかかわらず、最初のフェーズには分析環境の構築が待ち構えています。Dockerでコンテナーを立て、CLIから認証を通し、失敗したらログを読んで切り分ける。エンジニア以外にとっては、いきなり難易度の高いステージです。
結果として、初日に終わる人と2週間かかる人が出ます。本人の資質の問題ではなく、そうなる設計になっていたのが問題でした。
3つ目は、受け入れ担当の工数が読めないことです。
人が変わるたびに同じ説明を繰り返すので、環境構築とツールのレクチャーだけで想定以上の時間が溶けていきます。
対応の方針はこう整理しました。
| 課題 | アプローチ |
|---|---|
| 情報の散らばり | 散在した情報への導線を1つのGitHubリポジトリに集約する |
| 個人スキルへの依存 | AIエージェント(Claude Code)が伴走する |
| 工数超過 | 環境構築を、資料の取得から実行まで可能な範囲で自動化する |
新規メンバーがたどる導線を1本にする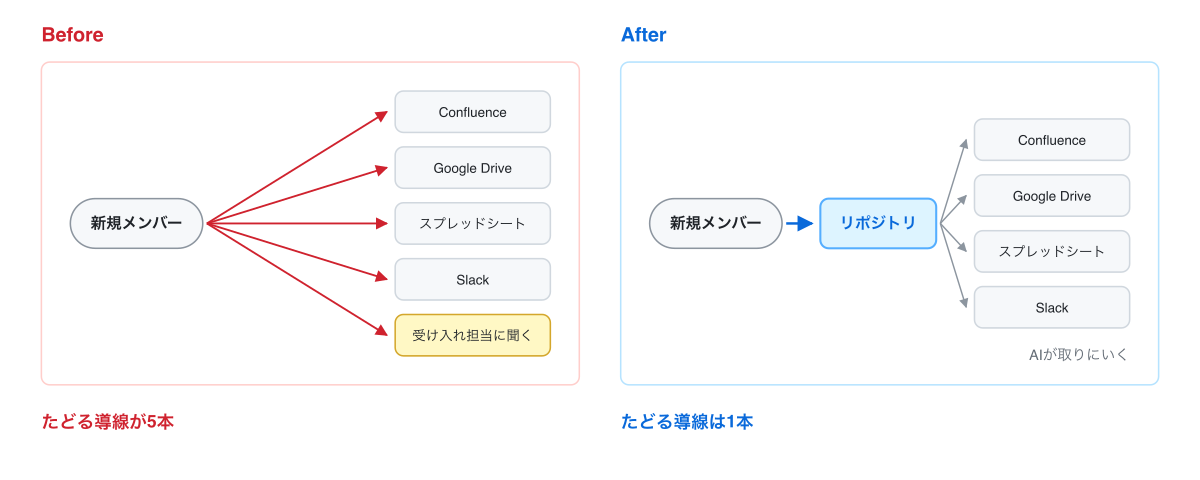
また、この構成により非エンジニアであるメンバーに「GitHubの使い方に慣れてもらう」「Claude Codeの使い方に慣れてもらう」ということも副次的に満たされることになります。
ゴールは「オンボーディングが終わった時点で案件にアサインできる状態になっていること」です。そのため、部のことなら何でも答える汎用Botを作ることは最初にスコープ外として明示しました。すべてエージェントで完結すると部の人とコミュニケーションを取る機会も減りますし、今回の目的は新規メンバーの立ち上がりを爆速にすること。加速器みたいなものなので必要最低限で良いという判断です。
作ったもの
そうしてできたのが、このオンボーディングリポジトリです。構成はシンプルにしました。
analyst-onboarding/
├── knowledge/
│   ├── sources.yml           # 正本レジストリ
│   └── guide/                # 学習ガイド(ゴール・勘所・完了判定)
├── docs/                     # チェックリスト、運用ドキュメント
├── workspace/                # 個人作業ディレクトリ(YYYY/名前/)
├── .claude/
│   ├── settings.json
│   └── skills/               # Claude Code スキル
└── CLAUDE.md                 # ドメイン知識・禁止事項
新規メンバーはこのリポジトリをcloneしてClaude Codeを起動し、スラッシュコマンドでオンボーディングを進めていきます。
| スキル | 用途 |
|---|---|
/setup-connectors |
教材の正本を読むためのコネクタ接続確認。最初に1回 |
/init |
ワークスペース・ブランチ・Draft PRの作成 |
/setup-env |
環境構築タスクをHuman-in-the-loopで順に消化 |
/onboarding next |
次にやるべき項目を案内 |
/onboarding progress |
進捗をフェーズ別に表示 |
/ask <質問> |
正本を引いて質問に回答 |
/daily-report |
日報を生成してワークスペースに保存 |
/feedback |
改善提案を improvements.md に蓄積 |
/maintain |
教材の鮮度点検と更新反映(受け入れ担当向け) |
いくつか気になるスキルもあるかも知れませんが、それはこれから説明します。
全体としては、次の3つの流れで進みます。
初日・毎日・気づいたら。それぞれの流れで使うスキルが決まっている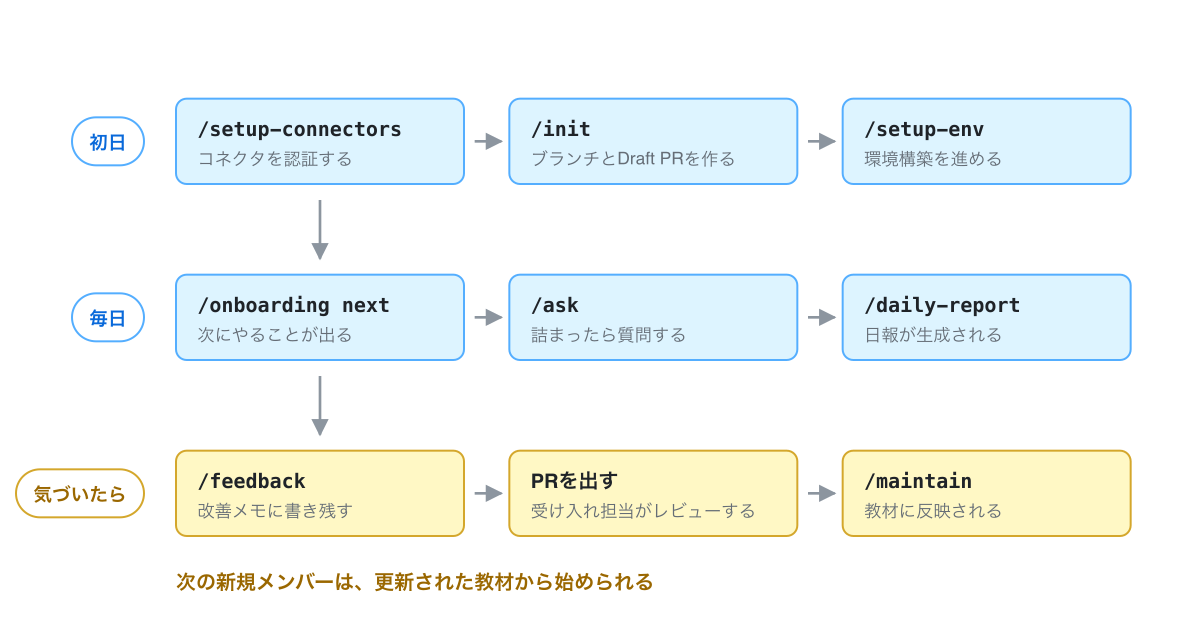
設計の話1:教材の本文は、持たない
ここからが本題です。
最初のバージョンでは、Confluenceやスプレッドシートの内容を外部サービスと接続するコネクタ機能経由で、せっせとMarkdownに転記していました。
リポジトリを開けば全部読める状態がいちばん親切だと思ったからです。
しかし、これは失敗でした。
転記した瞬間から、同じ情報がConfluenceとリポジトリの2か所に存在することになります。当然、正本が更新されてもリポジトリは追随しません。エンジニアっぽく言うとDRY原則違反ですね。
これだとオンボーディングごとの管理コストが嵩んでかえって面倒なので、方針を変えて本文の転記をやめました。
記録票(スプレッドシート)        ← 上流。項目一覧と正本URL
        ↓ 転記
knowledge/sources.yml          ← 正本の解決情報(page_id / file_id)
        ↓ 参照
knowledge/guide/ + checklist   ← id だけを持つ
        ↓ 実行時に取得
Confluence / Google Drive      ← 手順の本文
リポジトリが持つのは「正本がどこにあるか」と「その教材で何を身につけるべきか」だけです。
ゴール・勘所・完了の判定は書きますが、手順そのものは書きません。実行時にAIエージェントがコネクタ経由で正本を取ってきて、要点を圧縮して提示します。
この構造を維持するために、リポジトリの規約として次を明文化しました。
- 正本のURL・
page_id・file_idを書く場所はsources.ymlだけに限る - ガイドには
正本: <id>としか書かず、セクション名(アンカー)も書かない - 手順の本文はリポジトリで直さず、直すなら正本側で直す
アンカーまで禁止しているのは、Confluence側で見出しが変わった瞬間に参照が切れるからです。
二重管理は必ずどちらかが腐ります。ならば書ける場所を1つに絞ってしまえば、腐りようがありません。
リポジトリ側は数行。本文が更新されても、こちらは何も古くならない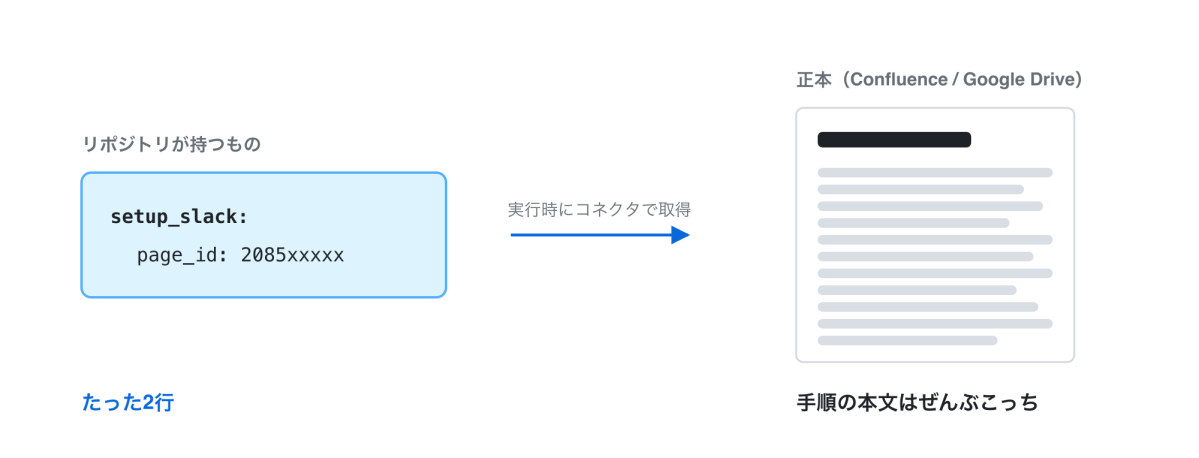
版が動く教材には「解決ルール」を書く
データ仕様書のように定期的に版が上がるドキュメントは、固定リンクを持たせた時点で負けが確定しています。
これらは sources.yml に固定IDを持たせず、「カタログから最新の承認済版を辿る」という解決ルールのほうを書くようにしました。
ここで1つハマりました。版の新旧を更新日時で判定してはいけないのです。
承認済みの版にも後から編集が入るので、更新日時が新しい版が最新版とは限りません。素直に従わせると古い版を参照してしまいます。最終的に、ファイル名に含まれる版の表記で判定するルールに落ち着きました。
正本は、Claude Codeのコネクタ機能で取りにいく
本文を持たない設計は、「必要なときに正本を取ってこられること」が大前提になります。ここをどう繋ぐかは少し迷いました。
結論としては、外部ツールとの連携はClaude Codeが持つコネクタ機能だけを使う方針にしました。
自前でMCPサーバを立てれば細かい制御はできますが、そのぶん新規メンバー全員の手元で同じように動く保証をこちらが持つことになります。オンボーディングの初日に「まずMCPサーバをセットアップしましょう」と言い出すのは、どう考えても本末転倒です。
コネクタであれば、新規メンバーがやることはブラウザから認証を1回通すだけです。使うものは3つに絞りました。
| コネクタ | 区分 | 用途 |
|---|---|---|
| Atlassian | 必須 | Confluence上の手順書 |
| Google Drive | 必須 | Drive / Docs / Sheets上の仕様書 |
| Slack | 任意 | 過去の質問ログ |
/ask で質問すると、AIは sources.yml から正本のidを引き、コネクタで本文を取得し、ガイドに書かれた勘所と突き合わせて回答します。
リポジトリには手順が1行も書かれていないのに、常に最新の手順が返ってくる。この状態を作れたのが、今回一番うまくいった部分だと思っています。
設計の話2:出力の形を固定する
スキルを書き始めた当初、/onboarding next の出力品質がまったく安定しませんでした。
自分で使っていてとくに気になったのが次の3点です。
- 読み手は次にやることだけ知りたいのに、冒頭に「#Xは保留」「#Yは受け入れ担当のタスク」といった判断の過程が並ぶ
- 手順書へのパスを示すだけで終わるので、毎回リンク先を開かないと作業できず集約した意味がない
- 手順書の条件分岐(「Intel版が入っていた場合は〜」)を全部展開するため、実際には踏まないケースの説明で本筋が埋もれる
同じタスクの案内でも、何を出して何を出さないかで読みやすさが変わる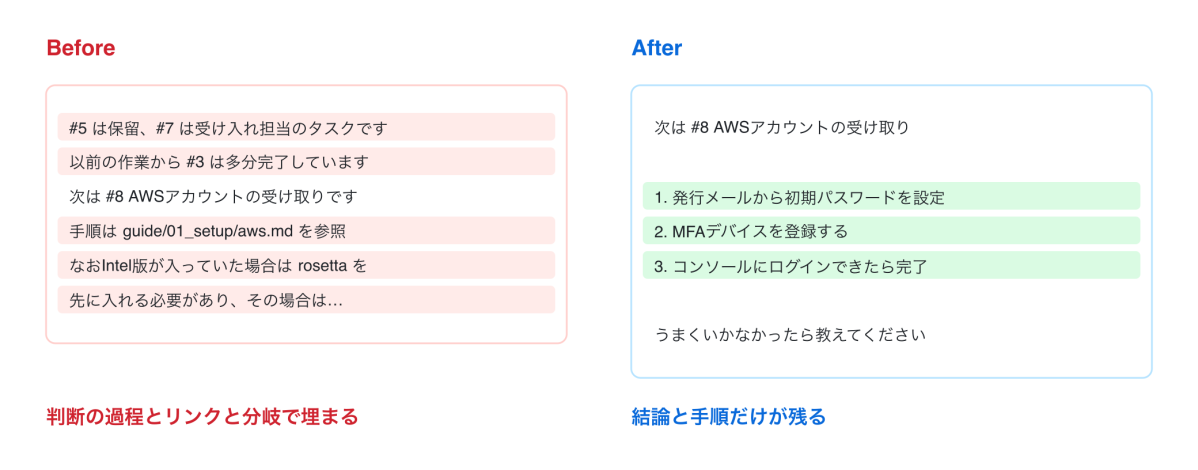
これらはモデルの性能の問題ではなく、期待する出力の形をこちらが書いていなかっただけでした。そこで SKILL.md に次のルールを足したところ、ぴたりと安定しました。
- 次のタスクは結論のみ提示し、スキップの理由や進捗の推測は聞かれたときだけ答える
- 手順書は読んだうえで3〜5ステップに圧縮し、複数画面のスクリーンショットが前提のものだけリンク誘導にとどめる
- 正常系の手順だけ展開し、分岐は書かずに「うまくいかなかったら詰まったポイントを教えて」と一文添える
3つ目には、新規メンバーに「AIに相談すれば解決できる」という体験を積んでもらう狙いもあります。
Claude CodeなどのAIツールを使い慣れていない人を複数人見てきた中で見つけた共通点として、「どこまでできるかわからない」もっと言うと「できると思っていない」ことが多いと感じています。おそらく読んでいる方でもできるかわからないけどとりあえずAIに聞いてみるくらいのノリで壁打ちをする人は多いと思います。この「とりあえず聞いてみる」という感覚に慣れてほしいという思いを込めてこのような挙動に制御しました。
成果物のフォーマットも決め打ちにする
出力が揺れて困るのは、対話の場面だけではありません。日報や改善メモのように残るもののほうが、揺れるとあとから効いてきます。
書式が毎回違うと、読む側つまり受け入れ担当の認知負荷が上がります。そのため、AIが生成する成果物はすべてテンプレートで決め打ちにしました。
| 成果物 | 決めた形 |
|---|---|
日報(daily_report/YYYY-MM-DD.md) |
やったこと / つまったこと / 明日やること |
改善メモ(notes/improvements.md) |
ステータス / 現状 / 問題 / 改善案 / 参照 |
チェックリスト(checklist.md) |
進捗の単一の情報源。日報の生成時に整合を確認する |
この中でもとくに改善メモについてです。せっかくオンボーディングを実施しているわけですからその中で思ったことやわかりにくかったポイントはすべてリポジトリへのFBとしてためておいて、オンボーディング終了時に改善メモをベースにリポジトリをアップデートするフィードバックループを盛り込みたいと最初から考えていました。なので5項目固定で丁寧に言語化しておくことで確実に使いづらさを潰せるようにしています。
日報については、当初「やったことをAIが質問してから書く」流れにしていました。ですが、AIのほうが新規メンバーの状況を行動記録から客観的に把握できます。なので、タスク進捗や困りどころは客観的にAIに書かせて新規メンバー本人には自由形式で書いてもらうという構成に倒しました。
設計の話3:AIにできないことを、先に決めておく
AIエージェントに任せると言っても、当然ながら任せられない作業はあります。
ここの線引きを先にやっておかないと、AIが「やったつもり」で先に進んで事故になります。
たとえばコネクタの認証はAI側から実行できません。認証用のツールを呼んでも「ユーザーに /mcp を実行させてください」と返ってくるだけです。
教材の正本がConfluenceとGoogle Driveにある以上、コネクタが繋がっていなければ何も読めません。そこで /setup-connectors を用意して、接続を確認してから先に進む流れにしました。
環境構築についても、CLIで完結する範囲は承認のうえAIが実行し、ブラウザ操作・申請フォーム・第三者への依頼は人に投げる、という切り分けにしています。
この切り分けは机上で決めず、実際に手を動かして測り直しました。
というのも、当初「自動化できる」と書いていた項目のうち、いくつかは実測すると人手が必要だったからです。自動化の可否には、書いた時点で希望的観測がかなり混ざります。ここは素直に負けを認めてドキュメントを訂正しました。
あわせて、AIが推測で答えないためのルールも CLAUDE.md に書きました。
正本が未登録の項目については「正本が未登録なので受け入れ担当に所在を確認してください」と答えさせ、手順を推測で埋めさせません。オンボーディング教材で嘘を教えると、新規メンバーはそれを検証する手段を持っていないので、ここは厳しめに縛っています。
エージェントの限界は、繋いでみてはじめてわかる
実際に動かしてみると、事前には想定していなかった限界も見えてきました。
1つは、長すぎるページをそのままでは扱えないことです。
全社共通のハブページのように十数万文字あるページは、1回のツール呼び出しに収まりません。必要なセクションに絞って取得する前提で組む必要がありました。
もう1つはより厄介で、取得の失敗をAI自身が判定できないという問題です。
ページの作られ方によっては、本文の一部が欠けた状態で取得されることがあります。AIから見れば取得は成功しているので、欠けたことに気づかないまま、それらしい内容で埋めてしまう余地が残ります。これが実際に起きた例は後半で紹介します。
元ページにある表が、取得した本文からは丸ごと消えることがある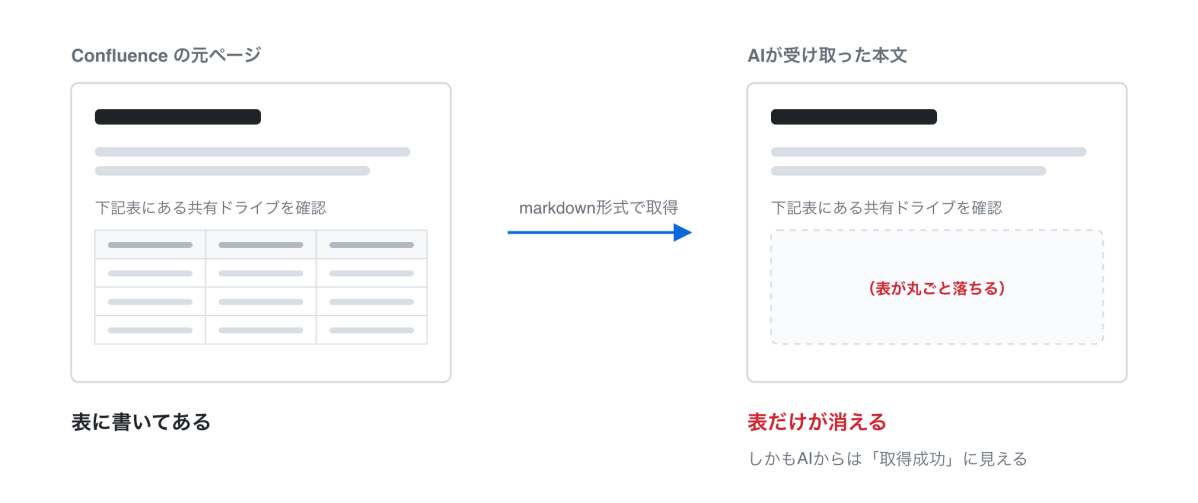
どちらも「モデルが賢くなれば解決する」類の話ではありません。繋ぎ込む側で手当てするしかない部分です。ここを知らずに「AIに任せれば全部読んでくれる」と考えると、静かに事故ります。
新卒が来ないので、AIに新規メンバーを演じてもらった
さてリポジトリは完成しました。しかし冒頭に書いたとおり、肝心の新卒は配属されませんでした。
プレイヤーのいないチュートリアルほど虚しいものはありません。
かといって、作った本人が触ってもまず詰まりません。書いた本人の前提が全部入っているからです。
そこで検証方法として、AIエージェントに新規メンバー役を割り当てて、初日のシナリオを頭から通してもらうことにしました。
これがよく効きました。観点を変えながら結局6周することになり、最後の1周でもまだ問題が出てきました。
観点を変えて6周。最後まで新しい問題が出続けた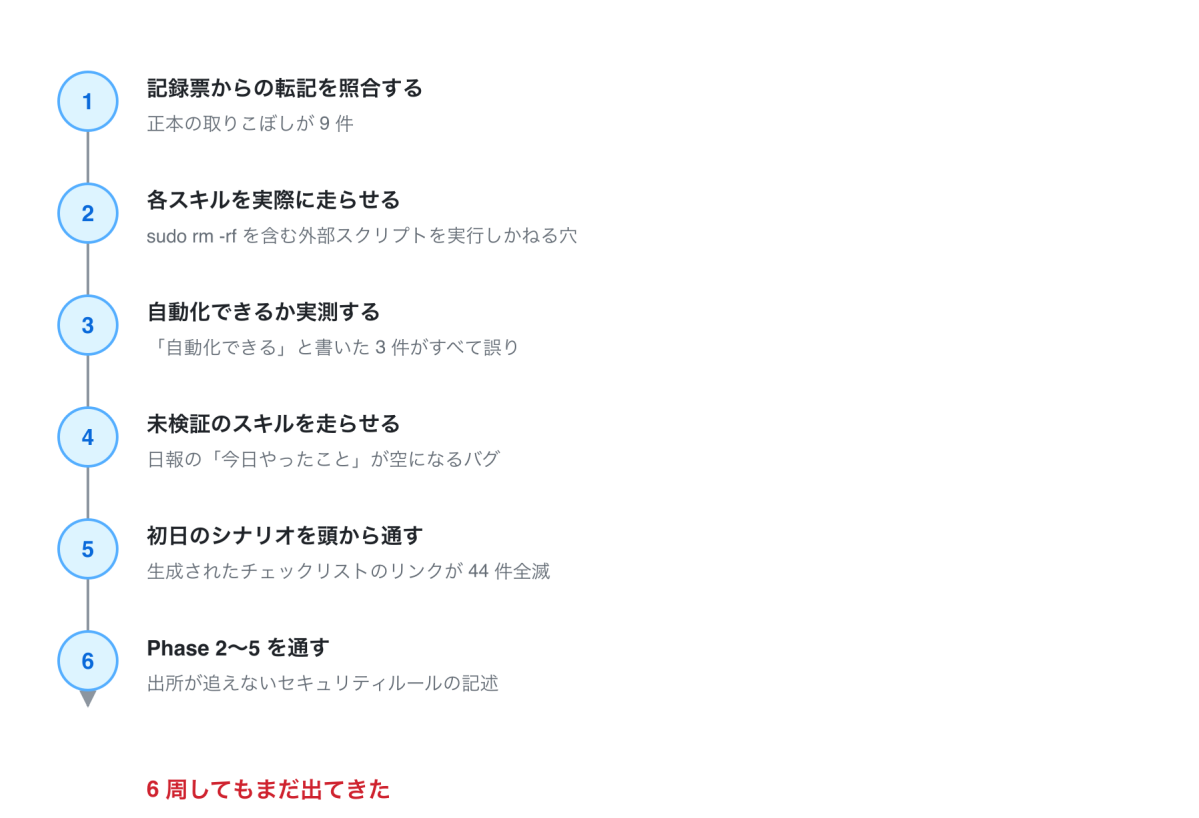
とくに、人間のレビューでは絶対に見つからないだろうと思ったものを挙げます。
チェックリストの依存関係が矛盾していました。番号順に進めると、多要素認証の設定より先にVPN接続の確認が来ます。VPNの初回設定には多要素認証が必要なので、番号順に素直に進むと必ず詰みます。教材を読める人ならその場で暗黙に回避してしまうので、レビューでは素通りします。
生成されたチェックリストのリンクが44件すべて切れていました。テンプレートは1階層浅い場所にあり、相対パスがそのままコピーされていました。テンプレートの位置で見ている限り正常に見えるので、実際に生成して踏むまで気づけません。
外部スクリプトを実行しかねる状態でした。手順にはDriveからスクリプトをダウンロードして実行する段があり、AIが見る文字列は禁止コマンドのどのパターンにも一致しません。中身には sudo rm -rf が13行ありました。
どれも指示どおりにしか動かない役がいて、はじめて表面化したものです。
ついに実戦投入:中途入社の方に1か月使ってもらった
そして8月。中途採用で新しいメンバーを迎えることになり、ようやくリポジトリの出番が来ました。
約1か月でオンボーディングが完了し、日報は毎営業日コミットされています。生身のプレイヤー、やはり強い。
そして一番の収穫は、教材の改善が本人から上がってくるようになったことでした。
/feedback で気づいた点を improvements.md に蓄積して、それをPRにする流れを用意してあります。実際に上がってきたものを、内容を丸めて紹介します。
- 権限の確認手順が実態と合っていない(メンバーが入れ子のグループとして登録されているため、自分の名前を探しても見つからない)
- 理解度チェックが、どの教材にも書かれていないことを問うている(読み落としを疑って延々と探し直すことになる)
- Confluenceの古い編集形式で作られた表が、Markdown形式で取得すると丸ごと落ちる(AIには「表がある」ことしか分からない)
3つ目のように、AIエージェント伴走ならではの不具合も出てきます。
表が落ちていることに気づかないまま推測で埋めれば事故になるので、取得形式を変えて取り直す手順をスキル側に足しました。
こうした指摘は、従来なら「自分の読み落としかもしれない」と飲み込まれて消えていたはずのものです。
改善提案を書く場所と、それをPRにする道筋さえ用意されていれば、新規メンバーの「分からなかった」がそのまま教材の資産に変わります。実際、本人が業務フローの手順ノートを書き足すコミットも積み上がっていて、リポジトリが勝手に育っている状態になってきました。
また、課題の1つであった環境構築は大丈夫か心配になるくらい爆速で終わったとのことで狙い通りといったところでしょうか。
せっかくなので、実際に使っていただいた感想を紹介させてください。
- 「この理解であっているかな?」というレベルの疑問点は、正本から正解・間違いを判断可能か、オンボ担当に質問が必要(=正本や接続されている資料等からは判断不可)かを振り分けられる
- 「あれ、どこかで読んだな…」をすぐに探せる
- 「これは初見な気がするけど、質問する前にclaudeに確認しよ」→本論ではやっていなくても、資料に関連事項があれば拾ってくる
- 「これは業界的には一般的なのかDeSCの慣例なのかわからないなあ」→一般的な場合は当然すぐ解決。社内慣例や実務での例があるかどうかも過去案件を遡って調べてくれる
- 「処理の前後関係や引数の参照先・元の理解があやしい」→ファイルに辿り着くためにフォルダの階層構造を自分で探す必要がないので時短、詳細説明までしてくれる
- CLIや関連webツールとシームレスにつながっているので、「環境構築系でつまづくポイントがほぼ自動で解決」する
- 「AI使わず自力で実装・記述が必要なオンボ内容はclaude codeは作業してくれない」のできちんと実力がつく(質問に対するアドバイスとかはくれる)
- Claude codeの使いこなしが業務改善に直結する部署&時期なので、オンボ全体が「claude code自体に慣れるオンボ」にもなっている点はレバレッジききそう
- 上記のようなやり取りを「学んだこと」として日報にまとめられるので学習効率がよい
運用して見えたこと
1か月動かしてみて、狙い通りだった部分と、当初は想定していなかった効き方をした部分が出てきました。
部が用意するものが、リポジトリ1つで済む
これまでは資料の場所を伝え、環境構築に付き添い、進捗を聞いて回る、という作業が受け入れ担当側に必要でした。いまは受け入れ日にリポジトリのURLを渡して「まず /setup-connectors と /init を叩いてください」と伝えるだけです。あとは本人とAIで進んでいきます。
進捗が、毎日文章で残る
日報が毎営業日コミットされるので、受け入れ担当は非同期で追えます。しかも「どこで詰まったか」まで書かれているので、わざわざ朝会で聞き出す必要がありません。従来のチェックシートは「終わったかどうか」しか分からなかったので、進捗の解像度が明らかに上がりました。
実務で使うツールに、オンボーディングそのもので慣れられる
進捗管理をブランチとPRで回しているので、コミットもレビューも自然と練習することになります。分析職でもGitHubを使う場面は多いので、初日からここが動くのは思ったより大きい効果でした。
質問のハードルが下がる
人に聞くには、相手の時間を取るという心理的な負荷がかかります。/ask があると、まずAIに聞いてから人に持っていけるので、聞く前に論点が整理されます。結果として、Slackに飛んでくる質問の粒度も揃ってきました。
設計として残った5つの学び
- 転記した瞬間に腐るので、リポジトリに集約すべきは情報そのものではなく導線のほうだった
- AIの出力品質はスキルの書き方で決まるので、モデルを疑う前に自分の指示を疑ったほうが早い
- 「自動化できる」は実測しないと嘘になる(書いた時点では希望的観測がかなり混ざる)
- 上流と正本は食い違うことがあるので、どちらを優先するかを先に決めておくとAIも人も迷わない
- 一番のバグ発見器はその仕組みをはじめて使う人で、AIに演じてもらうのはあくまで代用だった
まとめと今後の話
前回の記事でも書きましたが、何でもAIに任せるのではなく時と場合で責任範囲を調節するというのは今回も変わらず効きました。この考え方は1年経ってモデルが大幅に進化した今でも変わりません。認証は人、手順の要約はAI、教材の正しさの判断は人。この線引きを最初に整理して、人とAIがきれいに回る構図を作ってあげることが大事でした。
オンボーディングの仕組みは、作って終わりにすると次の受け入れまでに必ず古くなります。
使った人が改善を返してくれるフィードバックループを回し続けられるかどうかが、この取り組みの本当の勝負どころだと思っています。
近々また新しいメンバーを迎えます。
1周目で出てきた指摘を全部反映して、2周目はもっと滑らかに走ってもらう。まずはここを目標に整備を進めます。
引き続き、面倒なことはAIオールインで解決する。そんなマインドセットを大切に、最高のDelightを届けられるよう、初期衝動を忘れず頑張ります。
(追記)
本記事の構成や推敲にも、LLMの力を活用させていただきました。
さようなら、腐ったオンボーディング資料。ありがとう、すべてのLLM。

最後まで読んでいただき、ありがとうございます!
この記事をシェアしていただける方はこちらからお願いします。