


はじめに
はじめまして。2026年度DeNA AIスペシャリストサマーインターンシップに4週間参加させていただいた木暮緋南です。
今回のインターンでは、同期のインターン生と2人ペアで、DeNAが企画・運営する没入型体験施設「ワンダリア横浜 Supported by Umios」の公式アプリに向けた新機能を自分たちで企画しました。そして、その技術検証を行い、ワンダリア横浜の事業部の方に提案しました。本記事では、その企画と技術検証の内容、そしてインターンを通して得た学びを紹介します。
自己紹介
慶應義塾大学大学院 理工学研究科の修士1年です。大学では、都市の動きを時間方向も含めて3次元で再構成する都市動態の4次元再構成を研究しています。
本記事の内容
私たちが提案したのは、アプリを通して、まるでワンダリア横浜を貸し切ったかのような体験ができる「貸切ワンダリア」です。実際に施設を貸し切るのではなく、撮った写真に写り込んだほかの来場者がいなかったかのように編集したり、天井や床面などスクリーンの外側まで映像の世界を広げたりすることで、写真の中に「自分だけのワンダリア横浜」をつくります。これは、AR(拡張現実)を使ったARペットと、人物除去・写真編集の3つの機能を組み合わせたものです。
本記事では、まず企画に至るまでの流れを紹介し、その後3つの機能を順に説明します。とくに、私が担当した人物除去については、設計の意図や試行錯誤まで詳しく書きます。
ワンダリア横浜について
ワンダリア横浜の概要
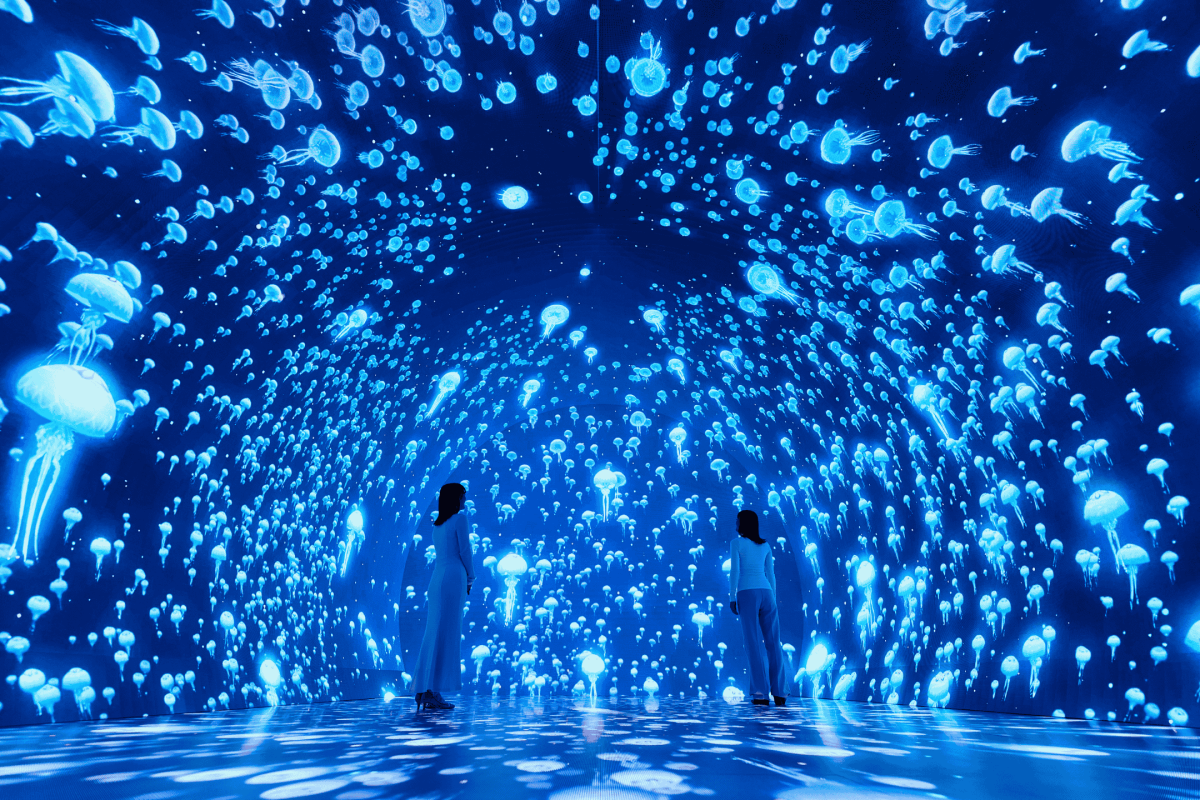
ワンダリア横浜 は、2026年3月に開業した、DeNAが企画・運営する没入型体験施設です。臨場感あふれる映像空間の中で、高原や深海などテーマの異なる6つのZoneを探索できます。関内駅から徒歩1分の「BASEGATE横浜関内」3・4階にある完全屋内型の施設で、体験後は併設のカフェやショップで余韻を楽しめます。
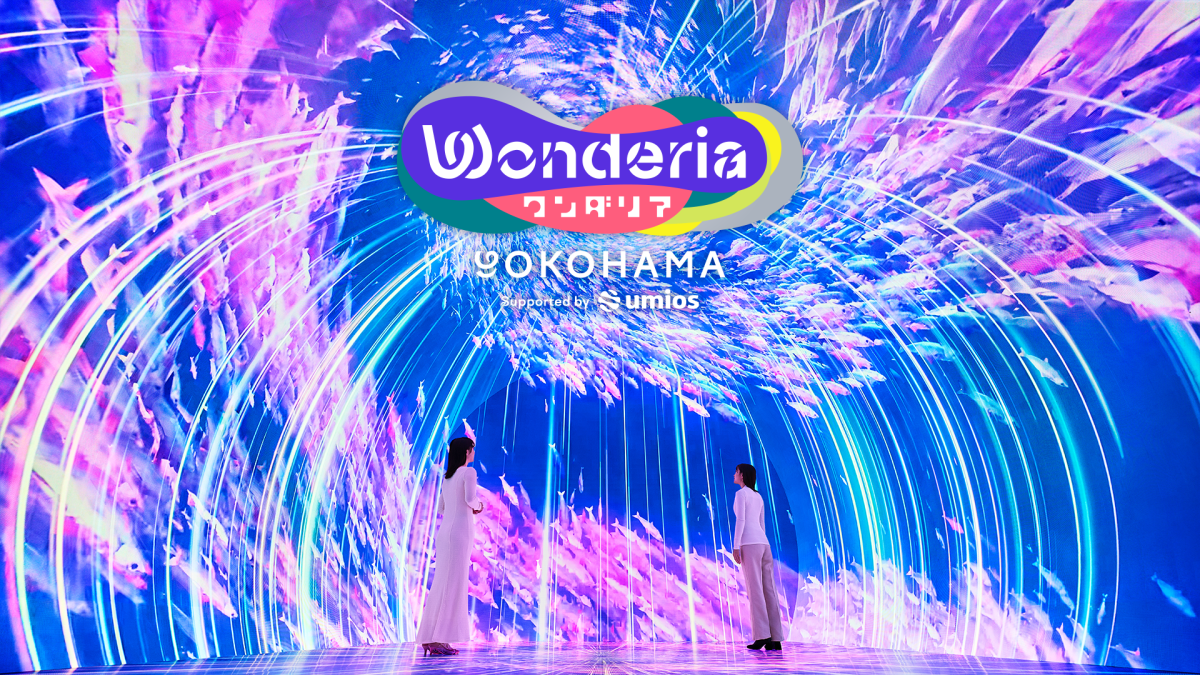
各Zoneは壁・床・天井の一部または全部がスクリーンになっていて、映像に囲まれた空間を歩けます。Zoneによっては壁や床が鏡になっていて、映像がどこまでも続いているように見えます。
既存アプリの機能
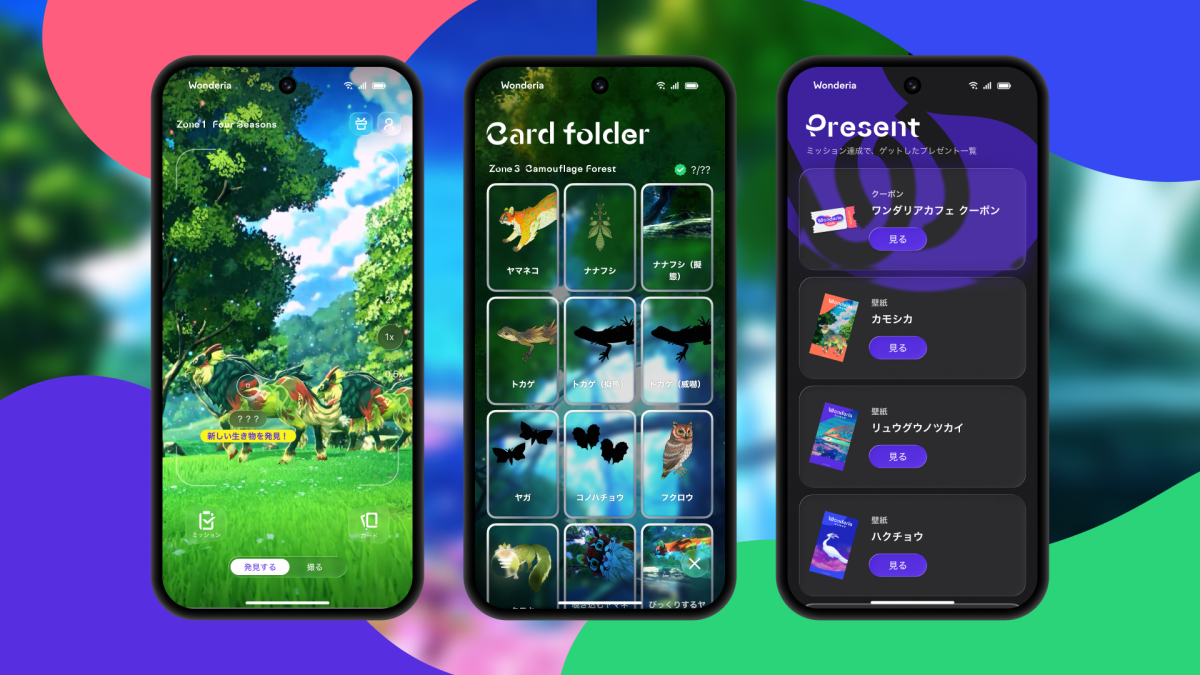
ワンダリア横浜には、体験をさらに深めるための施設公式アプリがあります。映像に登場する生き物のカードを80枚以上コレクションできるほか、施設内で使えるクーポンがもらえるミッションにも挑戦できます。主な機能は次の3つです。
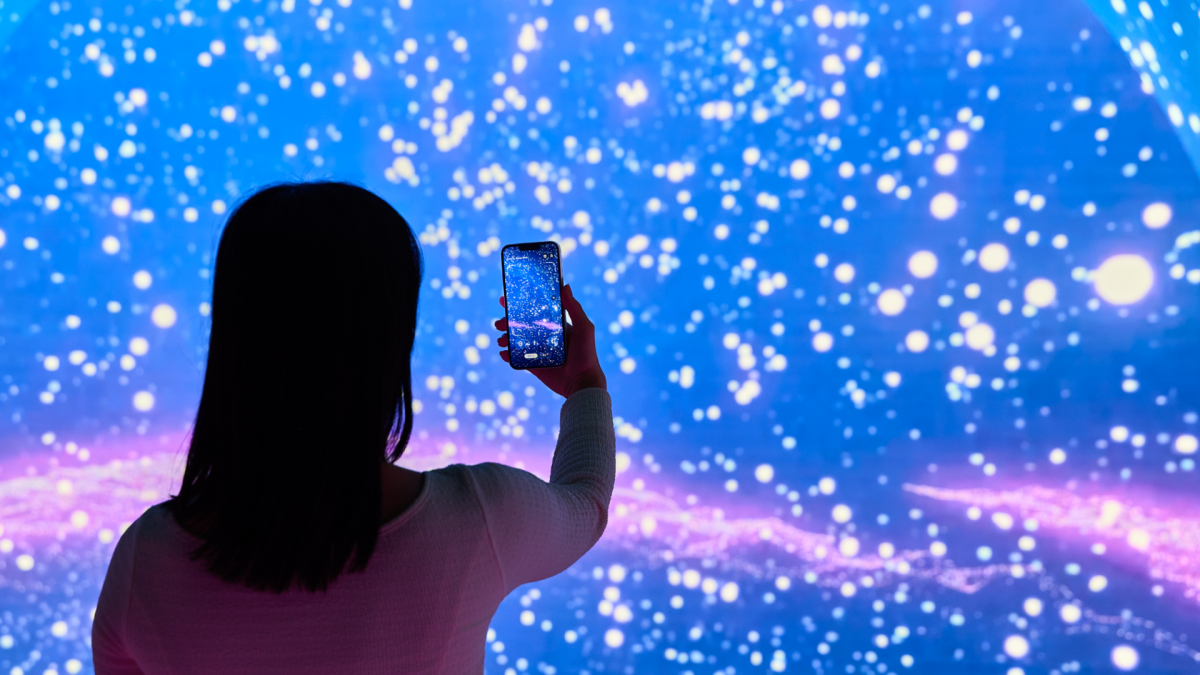
- かざして発見:映像空間にスマホをかざすと、映っている生き物をリアルタイムかつオンデバイスで発見できます。
- カードで学ぶ:ゲットした生き物のカードで、その生き物の情報を知ることができます。
- 巡って集める:Zoneごとに特有の生き物がいて、生き物を集めるミッションに挑戦できます。
かざして発見で使われているオンデバイスAIとは、クラウドに依存せず、モバイルデバイス上で直接AI機能を実行する技術のことです。
貸切ワンダリアの概要
今回のインターンで与えられたミッションは、「ワンダリアアプリの体験をさらに楽しくする新機能の考案と、その技術検証」でした。ミッションが決まっているのは施設だけで、何を作るかは自分たちで考える必要がありました。
なぜ貸切ワンダリアを作ろうと思ったか
私たちは、机の上で企画を考えるのではなく、まず現地に行くことから始めました。ワンダリア横浜は、映像に囲まれる空間そのものが体験の中心にある施設です。来場者がどんなふうに空間を楽しみ、アプリをどんな場面で使っているのかは、資料を読むだけではわかりません。何を作るべきかを考えるには、まず自分たちが来場者として体験してみることが一番だと考えました。
そこで、現地視察と事業部の方への提案を繰り返しながら、企画を磨いていきました。
1回目の視察では、まず来場者として施設を体験しました。その中で、私たちは次の2つの点で、体験をさらに広げられるのではないかと感じました。
- 映像を「見る」だけでなく、写真に残す楽しさも広げられそう:人気の施設なので多くの来場者でにぎわっていて、写真を撮るとほかの来場者が写り込むことがあります。
- 生き物を「集める」だけでなく、集めたあとの楽しみも作れそう:生き物を集めたあとも、ゲットした生き物と一緒に遊べる体験があれば、もっと楽しめそうです。
この気づきをもとに企画案を提案し、方向性を絞り込みました。
2回目の視察では、技術検証を意識して、Zoneごとの明るさやスクリーンの形、人の集まり方を確かめました。あわせて、人が写り込んだ写真、手を出した写真、自撮りなど、検証用の写真を各Zoneで撮影しました。この写真を使ってプロトタイプを作り、中間発表で見ていただきました。
3回目の視察では、中間発表で見えた課題に合わせて、必要な素材を狙って撮影しました。たとえば、登録した人を残す機能には同じ人を違うポーズで撮った写真、ARにはさまざまな角度で手を出した動画、写真編集には天井や床まで写った写真が必要でした。この素材をもとに検証を重ね、最終発表で提案しました。
回を重ねるごとに、視察は「体験する」ことから「確かめる」こと、そして「必要なものを撮りに行く」ことへと変わっていきました。そのぶん、企画も技術検証も、施設の実際の姿に合ったものになっていったと感じています。
こうして最終的にたどり着いたのが、「貸切ワンダリア〜新たな触れ合いを、映える1枚に閉じ込めて〜」です。3つの機能はそれぞれ独立したものではなく、1つの体験としてつながっています。
| 機能 | 体験 |
|---|---|
| ARペット | ゲットした生き物と、ARで手の上で一緒に遊べる |
| 人物除去 | 写真から人を消して、誰もいない「貸切」の空間を撮影できる |
| 写真編集 | 撮った写真を、ワンダリア横浜の世界に入り込んだような1枚に仕上げる |
視察とあわせていただいたフィードバックの内容と、それを受けて企画をどう変えたかは、後半の「事業部の方からのフィードバックについて」で紹介します。
活かせる環境と制限
技術検証にあたっては、次の活かせる環境と制限がありました。これらが、各機能の技術選定の理由になっています。
- 施設の映像・タイムスタンプ・Zoneを取得できる:再生中の映像のタイムスタンプや、今いるZoneは、アプリ側で把握できます。
- 今回の技術検証では、生成モデルの学習は行わない:ワンダリア横浜の生き物や映像を使った生成モデルの学習は行わず、既存のモデルや手法を組み合わせて検証しました。
- スマホの中だけで処理が完結することを目指す:サーバーに頼らず、メモリも計算資源も限られたスマホの中で動かすには、大幅な軽量化が必要です。
とくに「生成モデルの学習は行わないが、元の映像は参照できる」という条件は、あとで紹介する人物除去の設計に大きく関わっています。
ARペット
概要説明
ARペットは、アプリでゲットした生き物とARで触れ合える機能です。カメラの前に手を出すと、生き物が手の上に現れます。手の形によって動きが変わり、たとえばOKサインを出すと走り出します。今回の技術検証ではワンダリア横浜の生き物の3Dモデルではなく、CC BY 3.0で公開されているフリーの3Dモデルで代用しました。
課題
ARペットは、手を明確に認識していることが前提の機能です。ところが、ワンダリア横浜の館内は「映像を見るための空間」なので、スマホのカメラにとってはかなり厳しい環境です。映像の明るさはシーンごとに刻々と変わり、深海のような暗いシーンではそもそも手が見えにくく、明るいスクリーンを背にすると逆光で手が真っ黒に写ります。
実際に試すと、こうした瞬間に手の検出が途切れ、手の上の生き物が急に消えたり、関係ない場所に一瞬現れたりしました。せっかくゲットした生き物と触れ合う機能なのに、これでは没入感が台無しです。
アプローチ
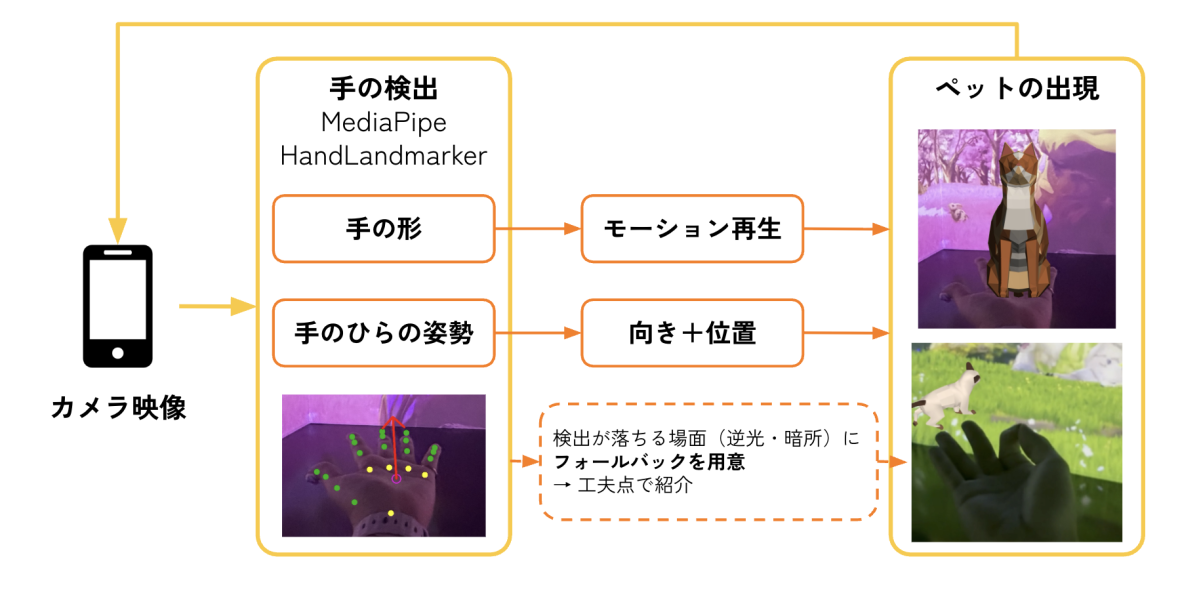
手の検出には、Googleが提供するオンデバイス向けの機械学習フレームワークMediaPipeのHandLandmarkerを使っています。検出した手のランドマークから、手の形を判定してモーションを切り替え、手のひらの姿勢から生き物の向きと位置を決めています。処理はすべてオンデバイスかつリアルタイムで完結します。
HandLandmarkerは、明るい場所ではとても安定して動きます。問題は暗所や逆光のときだけなので、HandLandmarker自体を別のモデルに置き換えるのではなく、「HandLandmarkerが失敗したときだけ助ける仕組み」を足すことにしました。普段の精度はそのままに、苦手な場面だけを補う考え方です。
工夫
フォールバックは、手の見え方に応じて3段階で切り替わります。
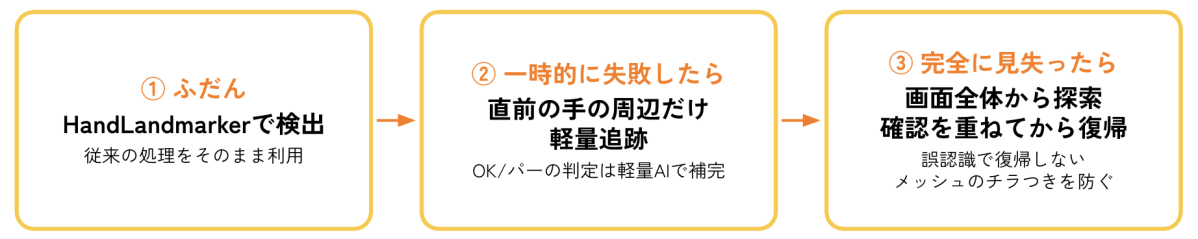
ふだんはHandLandmarkerでそのまま検出し、一時的に失敗したら直前の手の周辺だけを軽量に追跡します。このとき、手の形の判定は、明るさに応じて使い分ける小さなCNN(畳み込みニューラルネットワーク)で補っています。
とくに気をつけたのが、完全に見失ったあとの復帰です。見つけた瞬間に表示を戻すと、スクリーンの模様などを手と誤認して、生き物が変な場所に現れてしまいます。そこで、画面全体から手を探したうえで、確認を重ねてから復帰するようにしました。
追加したモデルは3つ合計で約1.1MBで、今回検証に使ったiOSのXcode Simulator上では1フレームあたり約30msと、30fpsに収まりました。
限界と今後
暗い場所ではまだ手を追い切れないことがあり、さまざまなライティング条件でのデータ収集と学習が必要です。また、現状はXcode Simulatorでの評価までなので、実機でのFPSや発熱の計測も今後の課題です。
人物除去
概要説明
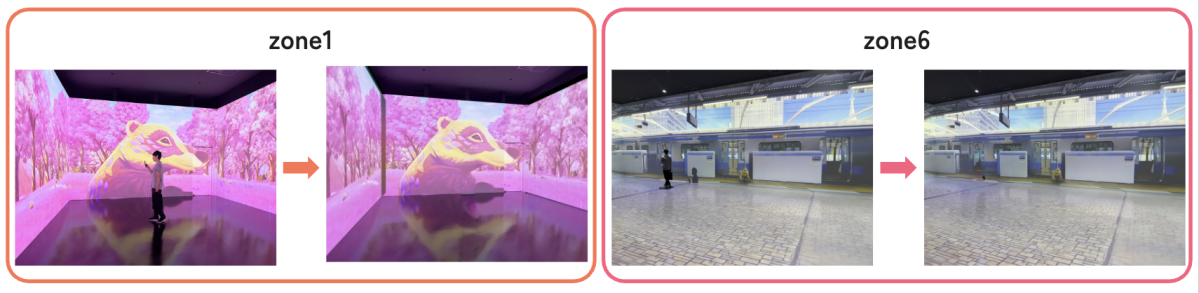
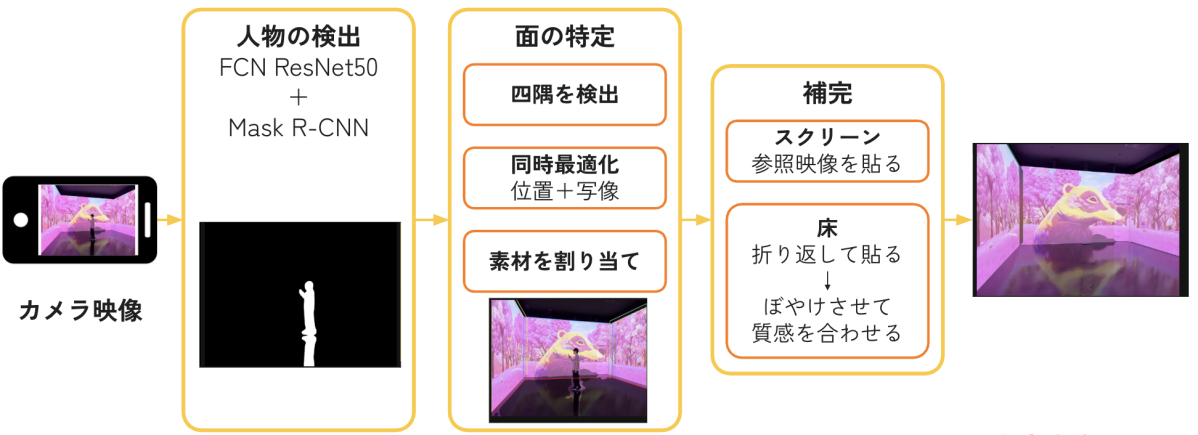
人物除去は、撮った写真に写り込んだほかの来場者がいなかったかのように編集して、誰もいない「貸切」のワンダリア横浜を撮影できる機能です。ほかの来場者がいた部分は生成で埋めるのではなく、同じ時刻に流れていた元の映像を貼って補完します。Zoneによってスクリーンの構成が違うため、今回はZone1とZone6に絞って技術検証を行いました。
課題
ワンダリア横浜は人気の施設なので、多くの来場者と空間を共有することになります。また、ワンダリアアプリで生き物を見つけるために立ち止まる人も多いため、映像空間で写真を撮ると、ほかの来場者が一緒に写ることがあります。
実際に口コミを調べてみると、投稿された写真の多くで、写り込んだ人の顔にモザイクやスタンプがかけられていました。写真を共有するときに、ひと手間かけている方が多いようです。
写真から人を消すために既存の人物除去やinpaintingのモデルを利用することはできますが、その方法では別の問題が生じます。人を消した部分に、元の映像にはない木や模様が生成されてしまうのです。ワンダリア横浜の映像は作り込まれた作品なので、それらしい別のものが描かれるのでは意味がありません。
アプローチ
そこで、ワンダリア横浜ならではの条件を使いました。映像のオリジナルデータを利用でき、撮影した瞬間のタイムスタンプもアプリで取得できます。つまり、「人の後ろに本来何が映っていたか」の正解が手元にあるということです。
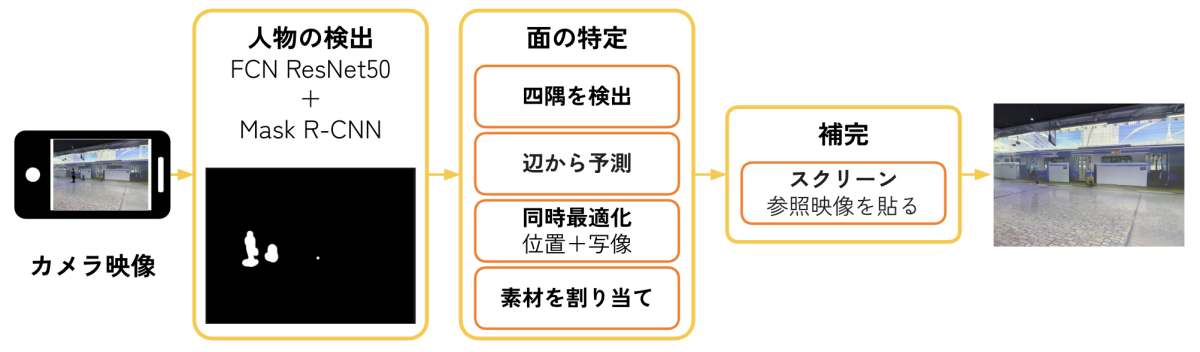
処理の流れは次のとおりです。
- 人物の検出:写真から人のマスクを取ります。
- 面の特定:写真の中でスクリーンがどこに、どんな角度で写っているかを求めます。
- 補完:スクリーン部分には、同時刻の参照映像を写真の見え方に合わせて変形して貼ります。
Zoneによってスクリーンの構成が違うため、2の面の特定および3の補完はZoneごとに設計を変えています。
| Zone | スクリーン構成 | 床の補完方法 |
|---|---|---|
| Zone1 | 壁のみスクリーン。床は少し反射する素材 | 壁の映像を床に折り返して貼り、ぼかして床の質感に合わせる |
| Zone6 | 壁と床の両方がスクリーン | 床にも参照映像を貼る。床の四隅は壁の辺から予測する |
工夫
人を見分ける
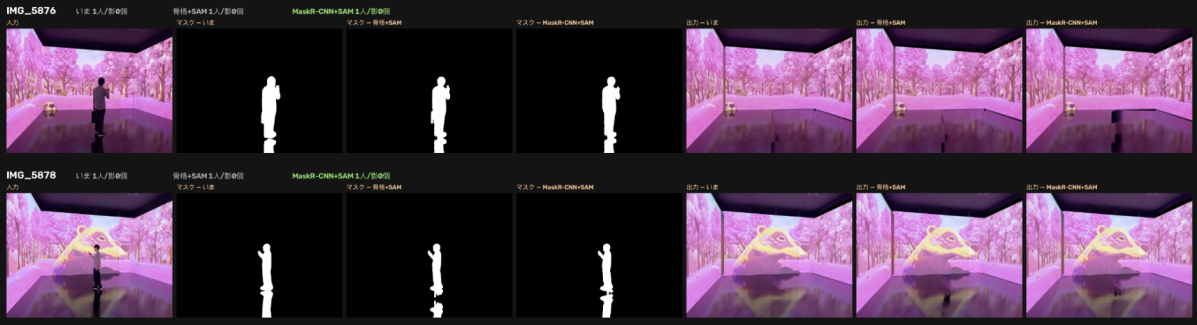
人物マスクには、FCN(Fully Convolutional Network)ResNet50とMask R-CNNの2つのモデルを併用しました。FCN ResNet50はセマンティックセグメンテーションのモデルで、画素ごとに人かどうかを判定するため輪郭を細かく取れますが、写っている人を1人ずつ分けることはできません。一方のMask R-CNNはインスタンスセグメンテーションのモデルで、人を1人ずつ分けて取れます。2つを組み合わせることで、細かさと個体の分離を両立しました。また、スクリーンに映った生き物や模様を人と誤認しないよう、投影物と人を見分ける処理も入れています。
面の特定と位置合わせ
写真の中のスクリーンの四隅を検出し、スクリーンの位置と、参照映像を写真に合わせる変換(射影変換)を同時に最適化しています。当初は特徴点がいくつ対応したかで位置合わせの良し悪しを判定していましたが、特徴点が多くても仕上がりが悪いことがありました。そこで、実際に貼り付けたときの仕上がりで評価する方式に変えました。
影も消す
人を消しても、足元やスクリーン上に影が残ると不自然です。影は、周りより暗くなっているところとして検出しています。
軽量化
最初のパイプラインは、ピークメモリが39GBもありました。スマホで動かすことを見据えて、次の順に軽量化しました。
- ピークメモリを計測し、どこがボトルネックかを分解しました。
- 画像全体ではなく、マスクの周辺だけを処理するようにしました。
- テキストエンコーダーの除去や量子化で、生成まわりを効率化しました。
- セグメンテーションモデルを差し替えました。
- 補完を生成モデルから古典的な方法に置き換えました。
| 指標 | 軽量化前 | 軽量化後 | 削減率 |
|---|---|---|---|
| ピークメモリ | 39GB | 2.5GB | 94% |
| 計算量(写真1枚あたり) | 142,887 GFLOP | 3,135 GFLOP | 98% |
GFLOPはGiga Floating Point Operations、つまり10億回の浮動小数点演算を表す単位で、処理にかかる計算量を示しています。
体験を増やす(人物除去の応用機能)
「写真に写った人を全員消す」だけでは、使える場面が限られます。現地で撮影したり口コミを見たりする中で、実際には次のような写真のニーズがあると感じました。
- 自分は写りたいけれど、不自然な影は消したい。
- 一緒に来た家族や友人は残して、知らない人だけを消したい。
そこで、人を全員消す機能に加えて、次の2つの機能を追加しました。
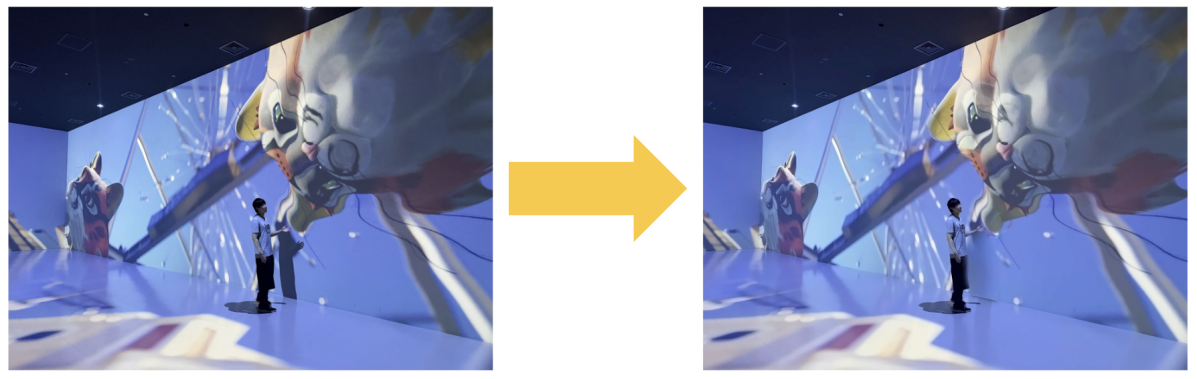
影だけを消す(Zone6)
プロジェクターを利用したZoneで映像の中に入り込んで写真を撮ると、スクリーンに自分の影が映り込んでしまうことがあります。自分は写りたいけれど、映像に落ちた影は世界観を壊してしまいます。人は残したまま影だけを消す処理は、画像編集AIでもうまくいかなかったので、取り組む価値があると考えました。
影は、スクリーン上で参照映像と比べて明るさが違う範囲として判断しています。参照映像という「影のない正解」があるからこそできる方法です。
登録した人だけを残す(Zone1)
口コミやブログの写真には人が写っているものが多く、人を入れて撮りたいニーズがあることがわかります。そこで、中間発表で事業部の方からいただいた「最初に人を登録しておいて、自動で消せるとよい」というフィードバックをもとに、この機能を作りました。
まずは、残す人を指定して、それ以外を消せるようにしました。次に、あらかじめ人を登録しておけば、その人を自動で見つけて残せるようにしました。登録画像と撮影した写真でポーズが大きく違っても、正しく特定できています。
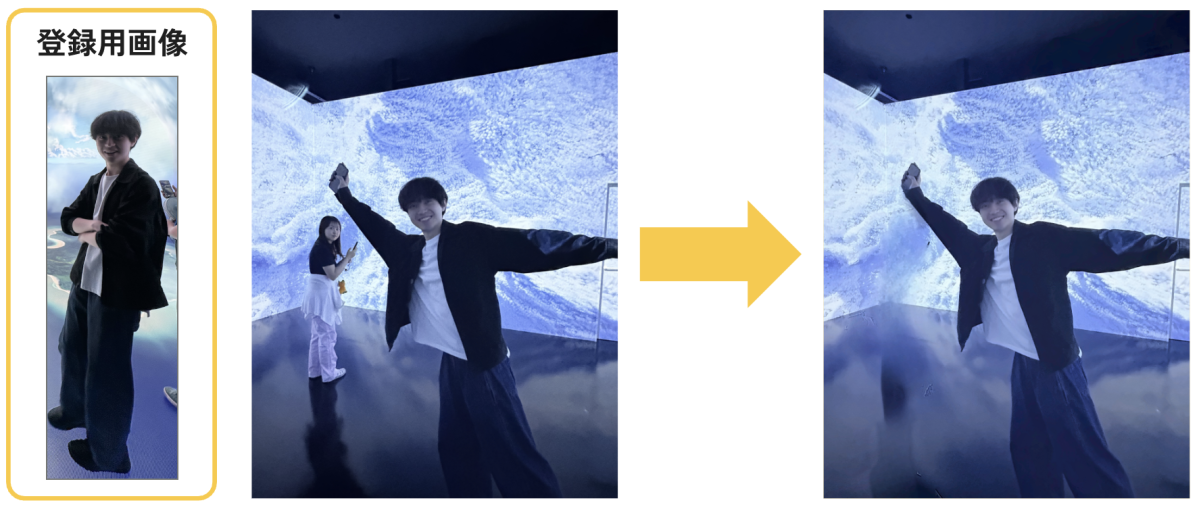
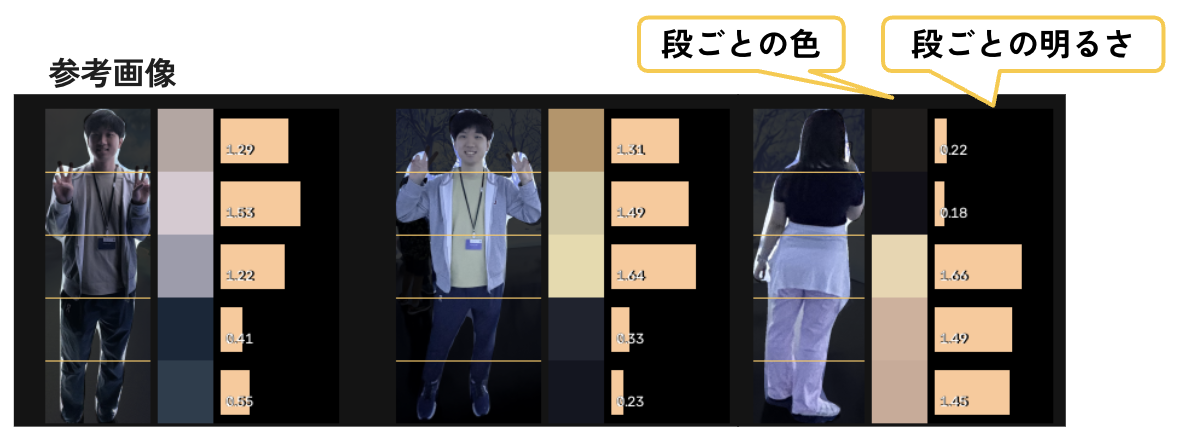
人物の特定には、顔認識などのモデルを使わずに、人物マスク内の色の情報だけで判断しています。スマホで動かすことを考えると、これ以上モデルを増やしたくなかったためです。手順は次のとおりです。
- 写真から人物マスクを取る(人を消すときと同じ処理)。
- 写真全体の画素の中央値でチャンネルごとに割り、部屋の環境光による色づきを取り除く。
- 人物マスクを縦に5段に等分する。
- 段ごとに、3チャンネル平均の中央値、R成分の中央値、B成分の中央値を取る。
- 登録画像の特徴と比べて、もっとも近い人を残し、それ以外を消す。
ポイントは2と3です。ワンダリア横浜はZoneごとに映像の色が大きく違うので、そのまま色を比べると、同じ服でも違う色に見えてしまいます。そこで先に環境光の影響を取り除いています。また、マスクを段に分けることで、「上は白いシャツ、下は黒いズボン」のような服装の組み合わせを手がかりにできます。ポーズが変わっても、頭から足元までの色の並びは大きく変わらないので、登録画像と違う姿勢でも特定できます。
限界と今後
現状の人物除去には、次の3つの限界があります。
- すべてのZoneには対応できていない:全Zoneに対応するには、各Zoneの特徴を捉えた設計が必要です。
- 構図によっては位置合わせができない:壁と床の境目がわかりにくい場合や、人が多すぎる場合です。
- 人から離れたところに落ちた影に対応できない:影の探索を人物マスクの周辺に絞っているため、処理量を抑えたまま探索範囲を広げる工夫が必要です。
今回対応したのは、6つのZoneのうち2つだけです。残りのZoneには、曲面のスクリーンや鏡の壁・床など、それぞれ別の難しさがあります。
| Zone | 状況 | 特徴・課題 |
|---|---|---|
| Zone1 | 検証済み | 比較的明るく、位置合わせも良好 |
| Zone2 | 未検証 | スクリーンが曲面で、位置合わせが課題 |
| Zone3 | 未検証 | スクリーン同士が接しておらず、プロジェクターの光の影響を受けやすい |
| Zone4 | 未検証 | 壁が鏡。暗い演出が多く、人のマスクを取るのが難しい |
| Zone5 | 未検証 | 床が鏡で、鏡像をうまく貼れない |
| Zone6 | 検証済み | 暗い映像だと位置合わせができない |
実運用可能なレベルに向けては、次の2つに取り組む必要があると考えています。
- 位置合わせの精度を上げる:古典的な方法や既存のモデルでは限界があったため、施設の写真を使って新たな位置合わせモデルを学習することや、施設を3Dモデルとして扱うことで、より正確な位置合わせができると考えています。
- ほかのZoneに対応する:鏡や曲面といった各Zoneの特徴に合わせて、Zone2〜5専用のパイプラインを作ります。
写真編集
写真編集は、館内で撮った写真を、ワンダリア横浜の映像の世界の中に完全に入り込んで撮ったような1枚に自動で編集する機能です。この機能は、スマホ上ではなくサーバー上で推論することを前提としています。
課題
ワンダリア横浜のスクリーンは迫力があり、現地では映像に包まれているような感覚になります。この没入感を、写真にももっと残せたらと考えました。写真には天井や床などの「映像の外側」も一緒に写るので、そこまで映像の世界が続いているように見せられれば、体験したそのままに近い1枚になりそうです。
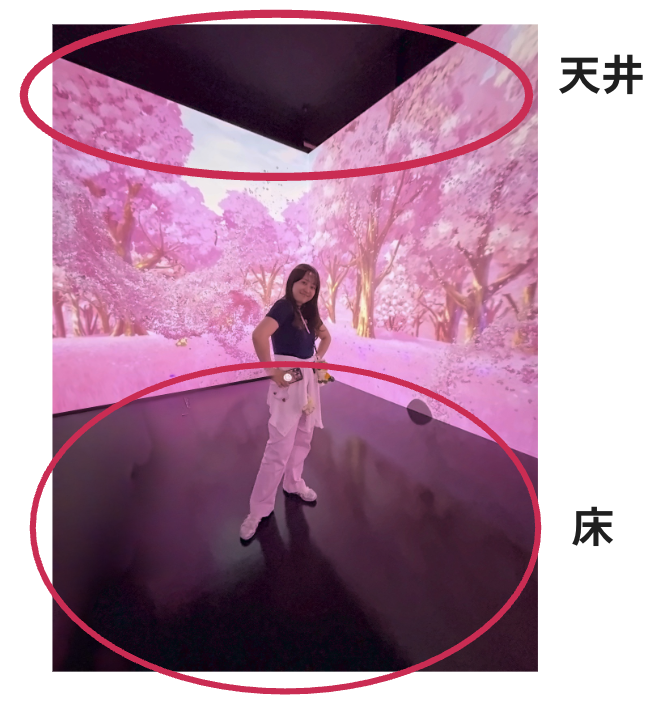
天井や床を描き変えるには、画像生成AIを使うのが自然です。ただ、写真全体をそのまま画像生成AIで編集すると、次の2つの問題があります。
- 人物の見た目が変わってしまう:顔や服装まで描き直され、「自分の写真」ではなくなってしまいます。
- スクリーンの映像まで描き直されてしまう:写真全体が生成し直されるため、映像そのものが改変され、ワンダリア横浜の世界観が損なわれてしまいます。
アプローチ
このインターンテーマに取り組むにあたって、映像素材を用いた生成モデルの追加学習は行わない前提で、人物とスクリーンの内容は変えずに、その周囲だけを生成する方針にしました。写真の中で「守る部分」と「描き足す部分」をマスクで分け、生成モデルには描き足す部分だけを任せる考え方です。
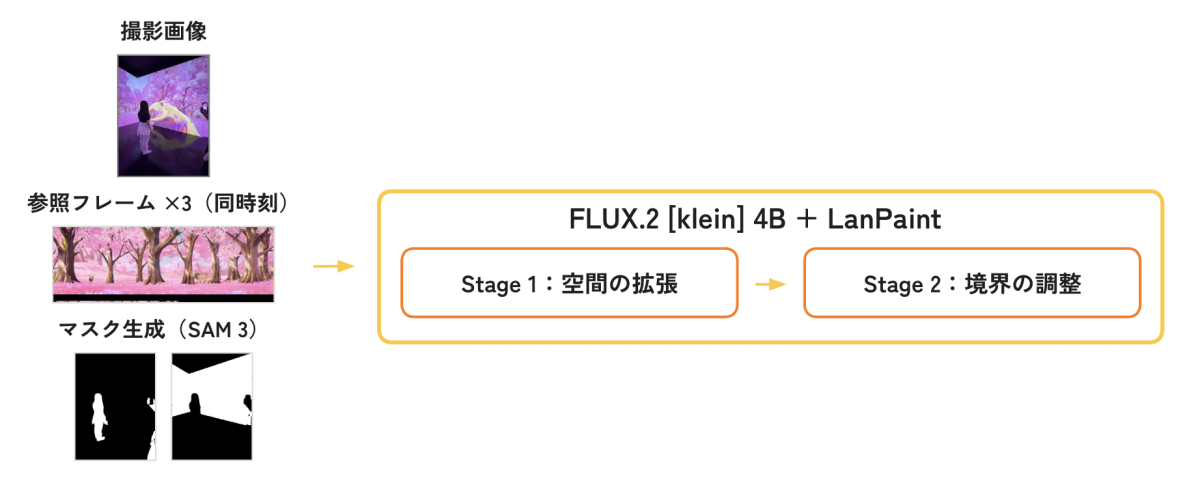
画像生成モデルのFLUX.2[klein]4Bに、学習なしでマスク条件を付けられる手法のLanPaintを組み合わせ、2段階で生成しています。マスクはSAM 3(Segment Anything Model 3)で作成しました。
- Stage 1(空間の拡張):天井・床・壁の部分だけを生成します。
- Stage 2(境界の調整):人物とスクリーンの内容を保ちつつ周囲の色味や質感をなじませる弱い編集を行います。
1段階だけで生成すると、スクリーン外の空間を広げる際に境界が不自然になりやすかったため、「空間の拡張」と「境界の調整」を2段階に分けることで、既存映像には手を加えずに自然なつながりを実現しました。
限界と今後
生成した天井や床を、スクリーンの映像と完全に違和感なくつなげることはまだ難しいです。また、現在は品質を優先していて、サーバー(RTX 4090)上で1枚あたり2分ほどかかっています。実用上は処理を大幅に軽量化する必要があると考えられ、さらなるパイプラインやモデルの改善が今後の課題です。
※本機能はインターンシップにおける技術実証(PoC)として考案・検証したものであり、ワンダリアアプリへの実装やリリースを予定・保証するものではありません。
※検証にあたっては映像の世界観とクリエイティブを尊重し、既存の映像をAIで改変・再生成することはせず、未投影エリア(天井や床面)の補完のみを対象としています。また、映像素材を用いた生成モデルの追加学習は行っていません。
今後の展望
今回の成果はあくまで技術検証で、実運用可能なレベルまでにはまだ差分があります。主なものは次のとおりです。
- ARペット:生き物ごとのモーション制作と表示サイズの調整、暗所での検出の安定化、実機での性能計測が必要です。
- 人物除去:ワンダリア横浜専用の位置合わせモデルの学習、3Dモデルへの拡張、Zone2〜5専用のパイプラインの構築が必要です。
- 写真編集:モデルの検証と、処理の大幅な軽量化が必要です。
生成モデルの分野は進歩が速いため、今後の技術の進化によって、写真編集の品質と速度はどちらも改善が見込めます。
技術検証を通じて得た学びと課題
事業部の方からのフィードバックについて
インターン期間中、事業部の方々からフィードバックをいただく機会が2回ありました。どちらも企画の方向を大きく変えるきっかけになりました。
1回目:企画段階
1回目の現地視察のあと、私たちはいくつかの企画案を持って提案に臨みました。そこで受け取ったのは、「今の体験のよさを大切にしながら、映像空間そのものとつながる体験にしてほしい」という方向性です。
自分たちの案を振り返ると、アプリの中で完結する仕組みに寄っていたり、はじめて来た人には伝わりにくかったりするものもありました。そこで、映像空間と直接関わる体験に絞り込むことにしました。中でも反応がよかったARと、写真を組み合わせた形が、貸切ワンダリアの出発点です。
2回目:中間発表
2回目は、人物除去やARのプロトタイプを実際に見ていただきました。方向性には手応えを感じられた一方で、「汎用的な技術ではなく、ワンダリア横浜という空間に特化したものにしてほしい」という声をいただきました。
これを受けて後半は、実際の来場者が使う場面をより具体的に想定して取り組みました。人物除去の軽量化(メモリ1〜2GB程度が目標)、一緒に来た人を残す機能、天井や床を生成する写真編集、そしてARの安定性を高めるフォールバックは、いずれもこの時期に形にしたものです。
技術的にできるかどうかだけでなく、「本当にユーザーにとって嬉しいのか」「実際に使える機能にするには何が必要か」を事業の視点から問われたのは、大学の研究ではなかなか得られない経験でした。
インターンシップ全体を通して
今回のインターンで唯一の2人チームだったこともあり、2人だからこそ成果を出さなければというプレッシャーもありました。一方で、2人だからこそできたことも多かったです。案出しではお互いにたくさん壁打ちをし、実装では機能ごとにはっきり役割を分担して、ある程度進んだら共有・相談するという進め方をしました。一番近くに、一番苦労をわかってくれる相談相手がいて、行き詰まったときや方向性がずれそうなときに、お互いが良いストッパーになれました。
私自身にとって一番大きかったのは、「技術的にすごいもの」と「使う人にとって嬉しいもの」は違う、と身をもって知れたことです。人物除去を作り込んでいた時期、メンターの方から「難しい技術を使っても、いらない機能では評価されない」「本当に良いかを確かめられるデモから逆算して作るとよい」と言われました。それからは、何を作るかの前に、誰のどんな写真をよくしたいのかを考えるようになりました。
実データの難しさも痛感しました。大学では都市の4次元再構成を研究していて、位置合わせや3次元の扱いにはある程度慣れているつもりでした。しかし、暗い映像、鏡の床、曲面のスクリーン、大勢の人と、現地の写真は想像以上に手強いものでした。色の補正や境目の処理を夢中で試し続けて、途中で「このまま続けても意味がない」と立ち止まり、方向を変えたこともあります。研究で培った考え方が役立った場面もあれば、条件がそろった研究のデータとは違う難しさに向き合う場面もありました。
もう1つは、実運用を見据えた視点です。最初の人物除去はメモリを39GBも使っていましたし、実運用時のライセンス条件や商用利用の制約を見据え、利用するモデルの選定を慎重に見直したこともありました。「このモデルじゃないといけないのか」を何度も問い直した結果、最終的には生成モデルを使わずに2.5GBまで減らせました。精度だけでなく、軽さやライセンスまで含めて技術を選ぶことは、研究ではなかなか意識しない観点でした。
このインターンの一番の面白さは、実在する施設が舞台になっていることだと思います。わからないことがあれば現地に行って確かめ、検証用の写真が足りなければまた撮りに行く。そうやって何度もワンダリア横浜に足を運びながら、自分たちで課題を見つけ、企画を立て、技術検証まで進められました。
また、テーマの自由度が高いのも魅力です。何を作るかから自分たちで考えられる一方で、事業部の方に企画を直接見ていただき、フィードバックをもらえる機会もありました。メンターの方とは、数時間おきに相談できるくらいの距離感で、技術の話も企画の話もたくさん議論させてもらいました。自分の研究がサービスの中でどう活きるのかを知りたい人には、ぜひオススメしたいインターンです。
終わりに
実在する施設を舞台に、現地で感じた「もっと楽しくできそう」という気づきから企画を立て、技術を組み合わせて形にしていく時間は、とても刺激的で、あっという間でした。
メンターの孫さん、鈴木さんには、技術面でも企画面でも、たくさんの議論に付き合っていただきました。また、事業部の皆様には、お忙しい中フィードバックの機会をいただき、ありがとうございました。そして、ペアを組んで一緒に走り切ってくれた湯浅くんも本当にありがとうございました。
ワンダリア横浜は、実際に行くと映像の迫力に圧倒される施設です。ぜひ皆さんも足を運んでみてください。
最後までお読みいただき、ありがとうございました。
参考文献
- [1] MediaPipe HandLandmarker (手の検出)
- [2] SAM 3(Segment Anything Model 3) (マスク生成)
- [3] FLUX.2 klein 4B (画像生成)
- [4] LanPaint: Training-Free Diffusion Inpainting with Asymptotically Exact and Fast Conditional Sampling (マスク条件付き生成、 実装 )
使用した3Dモデル
ARペットの技術検証には、以下の3Dモデルを使用しました。
- “Kitten” by Poly by Google ( https://poly.pizza/m/dBJgGEu5bHW ), licensed under CC BY 3.0
- “Kitten” by Poly by Google ( https://poly.pizza/m/dBJgGEu5bHW ), licensed under CC BY 3.0. Modified: auto-rigged and animated with Anything World; idle front-leg pose corrected.
- “Kitten” by Poly by Google ( https://poly.pizza/m/dBJgGEu5bHW ), licensed under CC BY 3.0. Modified: animated with AnimateAnyMesh and hand-authored post-processing.

最後まで読んでいただき、ありがとうございます!
この記事をシェアしていただける方はこちらからお願いします。