


はじめに
はじめまして。2026年度DeNA AIスペシャリストサマーインターンシップに参加させていただいた、奈良先端科学技術大学院大学(NAIST)修士1年の浦辺 晴基です。普段はヒューマノイドロボットの全身運動制御に関する研究を行っています。
今回のインターンシップでは、4週間という限られた期間の中で、「EDGE POKER」というポーカーゲームアプリでの活用に向けたエクスプロイト戦略ポーカーAIの開発に挑戦しました。
本記事では、複数人卓のテキサスホールデムにおいてエクスプロイト戦略AIを実現することの難しさと、それを解決するために採用したアプローチ、そしてインターンで得られた具体的な成果についてご紹介します。
インターン課題の背景
EDGE POKERとは?
「EDGE POKER」は、DeNAと株式会社POKER ROOMがタッグを組んで開発したスマートフォン向けポーカーゲームアプリです。
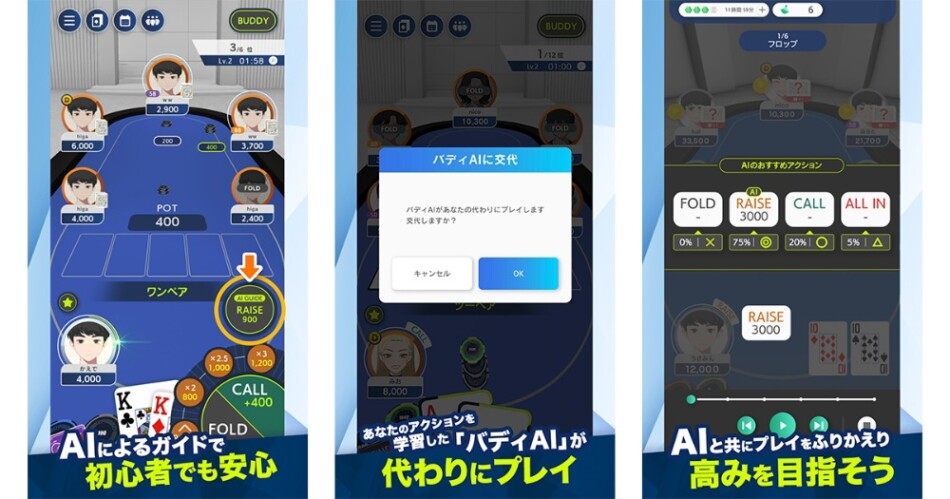
このアプリには、独自のポーカーAI「EDGE AI」が搭載されており、大事な場面でAIがおすすめのアクションを提示する機能や、プレイヤーのアクションを模倣してプレイを代行してくれる「バディAI」、プレイ後に自分のアクションを解析できる「AIふりかえり機能」など、ポーカーをより楽しむことができるための多くの機能が提供されています。
ポーカー(テキサスホールデム)とは?
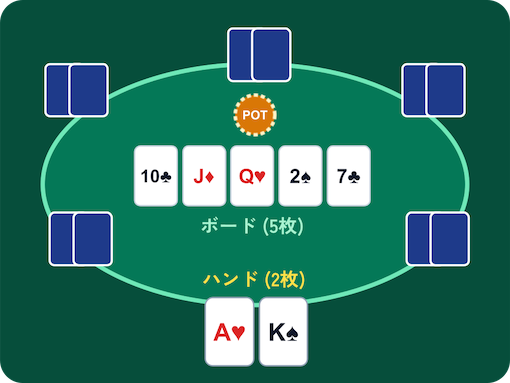
ポーカーは世界中で親しまれているトランプゲームです。「EDGE POKER」では、数多くの種類が存在するポーカーの中でも最もプレイ人口が多く主流となっているテキサスホールデムで遊ぶことができます。テキサスホールデムは、各プレイヤーに配られる2枚のカード(ハンド)と、場に公開されていく全員共通の5枚のカード(ボード、コミュニティカード)を組み合わせて役を作っていき、「強い役を作る」か「相手を欺いて勝負から降ろす」ことによって、自分のチップを増やすことを目指すゲームです。
プレイヤーは「チェック(何も賭けずにパスする)」「ベット(チップを賭ける)」「コール(相手と同額を賭ける)」「レイズ(相手よりも上乗せして賭ける)」「フォールド(勝負から降りる)」「オールイン(持っているチップ全てを賭ける)」といったアクションを行うことができ、相手のハンドが分からない不完全情報ゲームゆえの心理戦が魅力となっています。
ポーカーにおける2つの戦略
ポーカーの戦略は、大きくGTO戦略とエクスプロイト戦略の2つに分けられます。
GTO戦略(ナッシュ均衡戦略)
GTO戦略は「相手のどんな戦略にも搾取されない」ゲーム理論上の最適戦略です。
この戦略は、いかなる相手の戦略に対しても、長期的に見て自身の損失を最小限に抑え、安定した利益を追求するという目標を軸にしています。
じゃんけんを例にすると、「グー」「チョキ」「パー」をそれぞれ等しい確率(3分の1)でランダムに出すことがGTO戦略に当たります。この戦略を取れば、相手はどのような戦略で手を出したとしても勝率を上げることはできません。
相手のプレイスタイルに依存せず安定的に利益を得ることができる安全な戦略ではありますが、人間がプレイする限り自分自身にも対戦相手にも必ず偏りや弱点は存在するため、取り得た利益を取り逃す場合が多く、利益を最大化できる戦略ではないと言えます。
エクスプロイト戦略(搾取戦略)
一方、エクスプロイト戦略は「相手のミスや弱点を突く」ことで利益の最大化を目指す戦略です。
この戦略は、相手のプレイスタイルに存在する偏りや弱点に応じて自身の戦略を臨機応変に調整することで利益を最大化するという目標を軸にしています。
じゃんけんを例にすると、もし相手に「グー」を多く出す傾向がある場合、「パー」を出す確率を上げることがエクスプロイト戦略に当たります。
相手のプレイスタイルに対応した戦略を仕掛けることで、GTO戦略では得られない追加の利益を得ることが可能になりますが、自分自身もGTO戦略から逸脱してしまうため、逆に自分が搾取されてしまうリスクも伴います。
なぜEDGE POKERで「エクスプロイト戦略AI」が必要なのか?
「EDGE POKER」に搭載されているポーカーAI 「EDGE AI」はGTO戦略に近い戦略に基づいています。そのため、EDGE AIに依拠している現状の「AIふりかえり機能」ではGTO戦略に基づくアクション評価を提示しています。
先述の通り、GTO戦略は安定的に利益を得ることができる安全な戦略ではありますが、「対戦相手もGTO戦略である」という理論上の前提に基づいています。しかし、人間が実際にポーカーをプレイする場合、必ずプレイヤー固有の偏りやミスが存在するため、そのような前提が成り立つことは現実的ではありません。
そのため、現状の「AIふりかえり機能」のような、相手のプレイスタイルに依存しない基本戦略に基づくアクション評価だけではなく、相手のプレイスタイルに応じたより実戦的なアクション評価が求められています。
そこで、エクスプロイト戦略AIを開発し「AIふりかえり機能」に組み込むことで、「自分の隙を作らない基本戦略」だけではなく「相手の隙を逃さない実戦的な戦略」まで学ぶことができるようになり有用であると考えました。
また、対戦・解析ツールとして世に出ているポーカーAIのほとんどがGTO戦略ベースであり、エクスプロイト戦略AIを応用したプロダクトは世界的に見てもほぼ存在しないのが現状です。
「プロダクトとしての体験価値向上」と「先進的な社会実装への挑戦」を目指し、今回のインターンシップではエクスプロイト戦略AIの開発に取り組むことにしました。
エクスプロイト戦略AIの実現はなぜ難しいのか?
現在のGTO戦略AIは6人卓でトッププロの人間プレイヤーに勝利する領域にまで達していますが、エクスプロイト戦略AIに関しては2人卓や簡略化されたトイゲームでの研究が中心であり、複数人卓における実証例はほとんど存在しないのが実情です。複数人卓でエクスプロイト戦略を実行できるポーカーAIを開発するためには、以下の3つの主要な技術的障壁を乗り越えなければなりません。
技術的障壁
-
障壁1:人間の実プレイデータでは学習可能な局面が限定される
ポーカーでは、ハンドやボード、相手のアクションの組み合わせにより、非常に多様な局面が発生します。しかし、人間の実プレイデータを使用して学習を行う場合、実際のプレイで到達した特定の局面でのデータに限定されるため、あらゆる局面での対応を網羅的に学習することは不可能です。特に、珍しい局面や複雑な判断が求められる局面では、有効なデータを得ることが難しくなります。
-
障壁2:標的以外のプレイヤーから逆に自分が搾取されてしまうリスクへの対処
エクスプロイト戦略は、特定の相手の弱点を突くことで利益を最大化する戦略です。しかし、複数人卓では搾取対象以外の他プレイヤーも存在するため、標的のプレイヤーの弱点を突こうとGTO戦略から大きく逸脱したことで、他のプレイヤーから逆に自分の弱点を突かれてしまう場合があります。そのため、エクスプロイト戦略を適用する際には、標的以外のプレイヤーから搾取されてしまうリスクを最小限に抑えることが求められます。
-
障壁3:相手のプレイスタイルをリアルタイムで推定する難しさ
エクスプロイト戦略の要は、相手のプレイスタイルを正確に把握することにあります。しかし、対戦中の限られたハンド数から相手のプレイスタイルをリアルタイムかつ高精度に推定することは非常に困難です。
開発上の制約条件
これらの技術的障壁に加え、実際のプロダクト開発ならではの制約も存在しました。
- 計算コスト:大規模なAIモデルであるため、インターン期間中にモデル全体を再学習することは時間と計算資源の面から不可能でした。
- 推論コスト:アプリに組み込むAIとして、既存のリアルタイム性能を維持する必要がありました。
- 既存の入力構成変更不可:既存のEDGE AIの入力構成を大幅に変更することは困難でした。そのため、新たな情報を加える際にも、既存のモデルの枠組みを壊さない工夫が求められました。
- 多様な局面への対応:自分自身や標的とするプレイヤーの座席位置、ゲームに参加しているプレイヤーの人数に関係なく、標的のプレイヤーを搾取できるような実用的なAIを開発する必要がありました。
課題解決へのアプローチ
これらの技術的障壁と制約に対し、以下のようなアプローチで解決を図りました。
障壁1へのアプローチ:バディAIを利用した多様な局面での学習
「EDGE POKER」には各プレイヤーのアクションを模倣するように学習された「バディAI」が存在します。これを活用することによって、そのプレイヤーが実際にプレイした局面以外であっても、そのプレイヤーがどんなアクションを行うのかを仮想的にシミュレーションすることができ、多様な局面での学習データを大量に生成できるようになります。これにより、人間固有の多様なプレイスタイルに応じたエクスプロイト戦略を幅広い状況で学習できるようになりました。
障壁2へのアプローチ:搾取性と被搾取性のバランスを担保するアクション評価
AIに最適なアクションを学習させるためには、各局面においてどのアクションがどの程度優れているのかを評価する必要があります。そのアクション評価に用いるスコア関数を以下のように設計しました。
$$r(a)=[Q_t(a)-\mathbb{E}_{\text{base}}[Q_t]]-c \cdot \max(0, \mathbb{E}_{\text{base}}[Q_{b}]-Q_{b}(a)-\delta)$$
各記号の意味は次のとおり:
- $Q_t(a)$: アクション $a$ を取った後、標的がバディAIの戦略でプレイすると仮定したときの期待収支
- $Q_b(a)$: 同じ局面でアクション $a$ を取った後、標的がEDGE AIの戦略(GTOに近い戦略)でプレイすると仮定したときの期待収支
- $\mathbb{E}_{\text{base}}[\cdot]$: 自分(エクスプロイト戦略AI)がEDGE AIの戦略(GTOに近い戦略)でプレイした場合の期待収支
- $c$, $\delta$: ペナルティの強さと許容幅を決める定数(今回は $c = 2$、$\delta = 0.5$ を採用)
第一項はEDGE AIがプレイした場合と比べて、アクション $a$ が標的からどれだけ多く稼げるかを表しており、標的への搾取性に該当します。標的の弱点(GTO戦略からの逸脱)を突けるアクションほど大きな値になります。
第二項は標的の癖に依存しすぎている行動へのペナルティです。「標的が実は癖のない均衡的な相手だった」と仮定したとき、アクション $a$ がEDGE AIの戦略でプレイするよりも $\delta$ 以上損をするなら、その超過分に比例してスコアを減らします。つまり、「相手が癖のあるプレイをしたときだけ得をして、相手が標準的な癖のないプレイをすれば大損をしてしまう」ようなアクションがペナルティの対象です。
このペナルティがないと、搾取性だけが高い行動、たとえば「標的は慎重すぎてすぐに降りてしまう傾向があるから自身のハンドが弱くてもオールインする」といった、標的がもし降りなければ大きく負けてしまう行動ばかりが選ばれ、エクスプロイト戦略AI自身が隙だらけになります。第二項を加えることで、特定の相手の癖を突きつつ、均衡的な相手に対しても大きく負けない行動をAIに学習させています。この「搾取しつつ被搾取を抑える」という考え方は安全な搾取に関する先行研究と同じ方向性です。
障壁3へのアプローチ:サメ診断の情報を追加入力
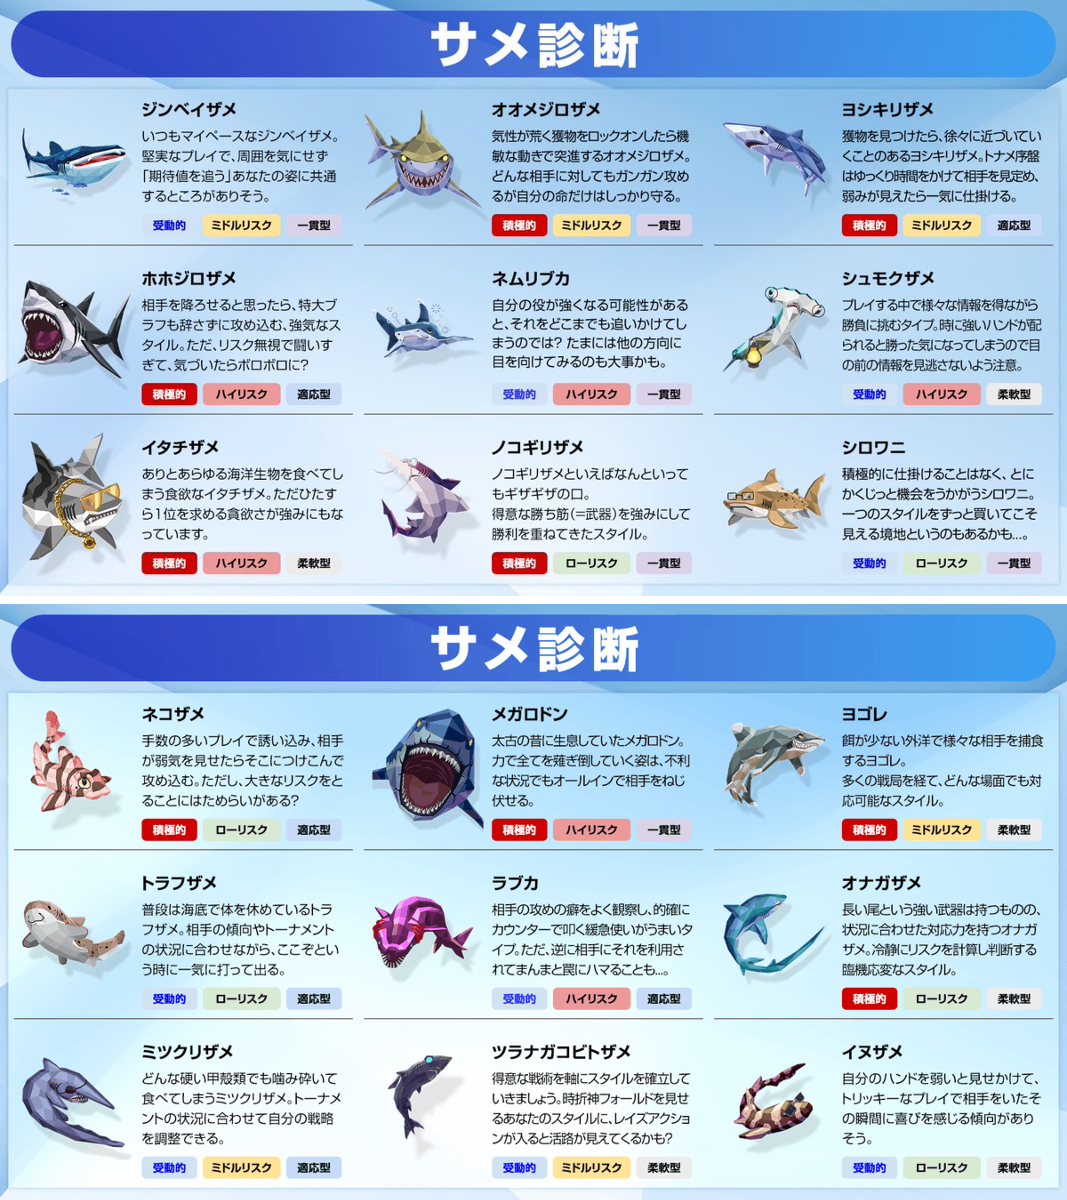
「EDGE POKER」には、プレイヤーを「主導性志向」「リスク志向」「柔軟性」の3つの軸で自動的に分析し、18種類のプレイスタイルに分類する「サメ診断」という機能が存在し、対戦中に各プレイヤーがどのサメなのか、すなわちどんなプレイスタイルなのかを確認することができます。標的のプレイスタイルを対戦中に数少ないハンドで正確に推定するのは困難であるため、今回はこの仕組みを活用しました。
既存のAIモデルの重みを凍結し、その上に小さな追加のニューラルネットワーク(MLP)を構築して追加学習を行いました。この追加のMLPに、標的プレイヤーの「サメ診断」の情報、相手のハンドレンジ(持っているハンドの候補となる範囲)の歪み具合、有効コンボ数(相手のハンドの候補が実質何通り残っているか)などのエクスプロイト戦略に必要な情報を追加入力として与えることで、既存モデルを大きく変更することなく、相手の癖に応じた戦略の切り替えを実現しました。
環境設定と学習手法
これらのアプローチを実現するために、以下のような環境設定と学習手法を使用しました。
環境設定
学習対象のAI、標的となるバディAI、その他4席にランダムなバディAI を配置した6人卓。標的の選定にあたっては、18種類のサメプレイスタイルを「主導性志向」と「リスク志向」の2軸で6つのクラスに集約し、弱点が多く搾取の余地が大きいバディAIを各クラスから50体ずつ合計300体を選びました。
学習データ
上記の環境で対戦を行い、学習対象の席に回ってきた約 2,000 の決定局面を収集。各局面で取り得る全アクションについて、アクションスコア $r(a)$ を求めました。
学習手法
各局面で、EDGE AI の方策 $\pi_{\text{base}}$ をアクションスコアに応じて重み付けした「目標分布」$\pi^*$ を作ります。
$$\pi^*(a) \propto \pi_{\text{base}}(a)\cdot \exp\left(\frac{r(a)}{\lambda}\right)$$
これは「スコアの期待値を最大化しつつ、EDGE AIからのKL距離にペナルティを課す」次の最適化問題の解析解になっています。
$$\pi^* = \arg\max_{\pi}; \mathbb{E}{a\sim\pi}[r(a)] - \lambda, \mathrm{KL}(\pi ,|, \pi{\text{base}})$$
$\lambda$ が大きいほどEDGE AIに近い分布になり、小さいほどスコアの高いアクションに寄ります(今回は $\lambda = 2$ を採用)。
各局面の $\pi^*$ を教師データとして、追加MLPの出力分布が $\pi^*$ に近づくように交差エントロピー誤差を用いて学習を行いました。
評価結果
開発したエクスプロイト戦略AIの性能を検証するため、大規模なシミュレーションと評価を行いました。
評価設計と指標
- 検証環境:学習に用いたバディAI(260体)とは異なる未見のバディAI(40体)を評価に用いることで、汎用性を確認しました。シードを統一し、10万ハンドという大規模なシミュレーションを繰り返すことで、統計的に信頼性の高い評価を行いました。
- 評価指標:以下の3つの観点からAIの性能を評価しました。
- 総合力:卓全体での絶対収支
- 防御力:GTO戦略への堅牢性
- 攻撃力:標的の弱点を突いたことで得られた収支
定量評価の結果
シミュレーションの結果、開発したエクスプロイト戦略AIは、既存のEDGE AIと比較して大幅な性能向上を示しました。
【補足】収支の単位「bb/100」について
ポーカーの収益率を表す標準的な指標で、「100ハンドあたり、ビッグブラインド(bb)何個分を平均で稼いだか」を示します。bbは各ハンドの開始時に定められた強制ベットの額で、レートの異なる卓どうしでも成績を比較できます。
-
卓全体での絶対収支:
評価対象のAI、標的となる評価用バディAI、その他4席にランダムなバディAI を配置した6人卓における、評価対象のAIの絶対収支の量は
- EDGE AI:+27.1 bb/100 (±5.8)
- エクスプロイト戦略AI: +52.9 bb/100 (±6.4)
となり、既存モデルから約2倍の収支向上を達成しました!
-
GTO戦略(EDGE AI)への堅牢性:
エクスプロイト戦略AIとEDGE AI 5体を配置した6人卓における、エクスプロイト戦略AIの絶対収支の量は -0.5 bb/100 (±3.8) となり、GTOに近い戦略を相手にした場合であっても大崩れすることなく、ほぼ互角の勝負ができています!
-
標的の弱点を突く収支:
1の評価結果から、評価用のバディAIを標的にした場合、エクスプロイト戦略AIはEDGE AIよりも収支を +25.8 bb/100 (±4.2) 多く獲得できたことが確認できます。
一方、他の条件を全て統一した上で、元々評価用のバディAIが座っていた席にEDGE AIを座らせた場合、収支の改善量は +7.3 bb/100 (±2.2) となりました。
よって、収支改善量の差分を計算すると、標的由来の収支は +18.5 bb/100 (±4.4) であると言えます。
すなわち、エクスプロイト戦略AIがEDGE AIよりも収支を増やせたのは、標的の弱点を上手く突けたからこそであることを示しています!
定性評価の結果
実際のプレイにおけるエクスプロイト戦略AIの行動を分析することで、どのように相手のプレイスタイルに適応しているかを具体的に確認しました。
-
アグレッシブな相手への適応:
例えば、以下に示すように、自身がハンドにクイーンのポケットペア($Q\spadesuit Q\clubsuit$)を持っているときに、ターンでチェックしたところ、アグレッシブ(積極的)なプレイスタイルの標的からポットの総額を超える72bbの大きなオールインを打たれた場面を考えてみます。
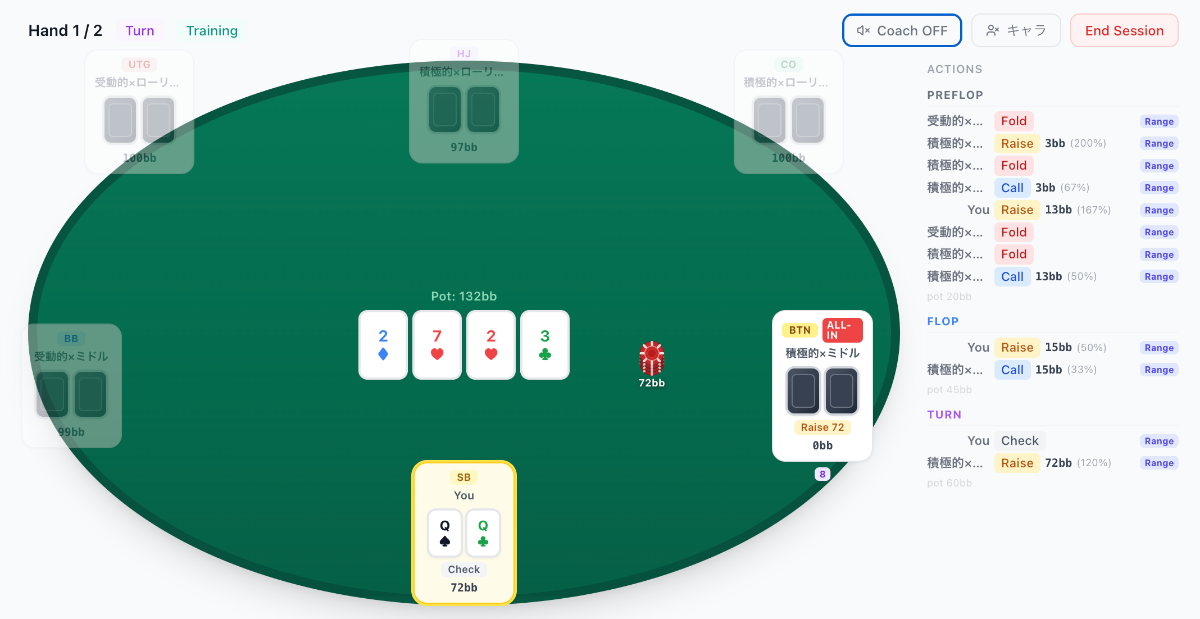
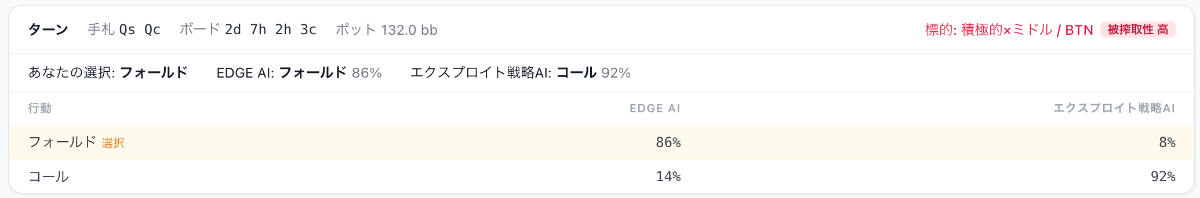
既存のEDGE AIの場合、相手からの大きなオールインベットに対して「相手は強い手札である」と判断し、この局面ではフォールドを86%の確率で選択します。
一方、エクスプロイト戦略AIの場合、アグレッシブな相手は必ずしも強いハンドでなくてもオールインしてくる傾向があると判断します。その結果、自分のハンドでも勝てる確率が十分あると見込み、この局面ではコールを92%の確率で選択します。
-
パッシブな相手への適応:
一方、パッシブ(受動的)な相手に対しては異なる適応を見せました。例えば、以下に示すように、自身が $9\clubsuit 7\clubsuit$を持っており、フロップで7のワンペアができた後、ターンへと移った場面を考えてみます。 パッシブ(受動的)なプレイスタイルの標的から7bbの控えめなベットが打たれた後、自分に順番が回ってきた場面です。
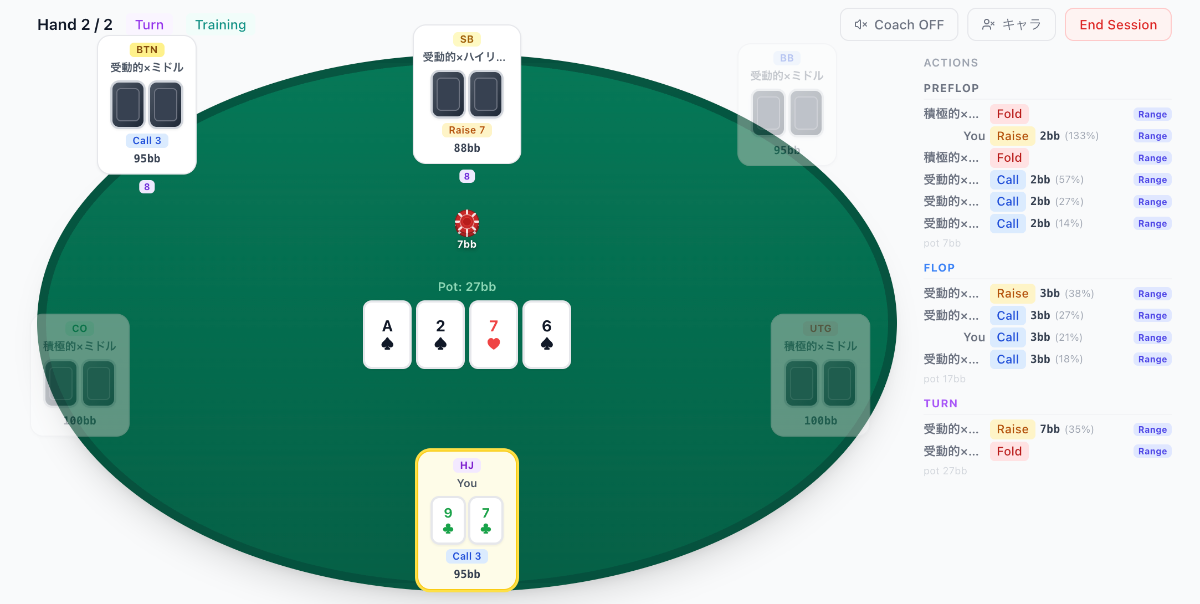
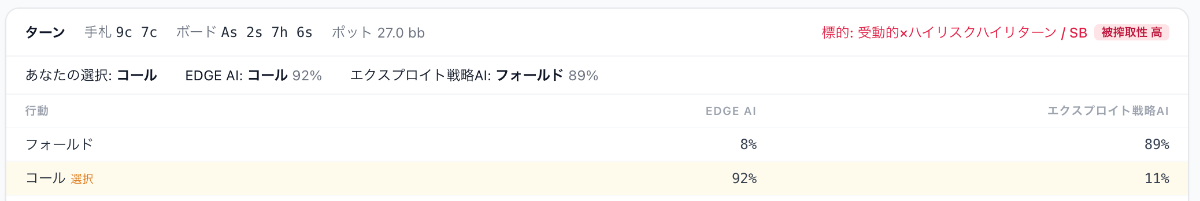
既存のEDGE AIの場合、この局面では得られるチップ量を踏まえた上で92%の確率でコールを選択します。
一方、エクスプロイト戦略AIの場合、パッシブな相手が自らベットしたことで「標的は非常に強いハンドを持っている」と判断し、中途半端な手札では勝ち目がないと判断してこの局面では89%の確率でフォールドを選択します。
まとめ・今後の展望
本インターンシップでは、ポーカーゲームアプリ「EDGE POKER」での活用を目指し、複数人卓テキサスホールデムにおけるエクスプロイト戦略が可能なポーカーAIの開発に取り組みました。既存のEDGE AIモデルにバディAIやサメ診断を活用した追加学習を行うことで複数人卓でのエクスプロイト戦略を実現し、既存のEDGE AIと比較して約2倍の収支向上を達成できました。また、相手のプレイスタイルに応じて戦略を切り替えることができるようになったことを定性的に確認することができました。
残された課題として、以下が挙げられます:
- 人間プレイヤーへの適用:今回はバディAIを相手とした評価でしたが、実際の人間プレイヤー相手にどれだけ搾取できるか、あるいは逆に搾取されないかの検証が必要です。
- リアルタイム適応:アクション履歴からリアルタイムに相手の戦略を推定し、より動的に適応できる方法を模索することで、さらに汎用性の高いエクスプロイト戦略AIを開発できると考えています。
おわりに
DeNAのサマーインターンシップに取り組んだ4週間は非常に濃密で有意義な時間となりました。ポーカーのドメイン知識も「EDGE POKER」への理解もほとんどない状態から、かなり挑戦的な課題に取り組むこととなり不安も大きかったですが、どうにか成果としてまとめ上げることができ、大きな達成感を得ることができました。
毎週大阪から東京へ新幹線で通うハードなスケジュールではありましたが、野球観戦・ポーカー会・ランチ会など、他のインターン生や社員の方々と交流させていただけるイベントも多く、終始楽しく充実した日々を過ごすことができました。
お忙しい中、何度も相談に乗ってくださり、成長につながる的確なフィードバックをくださったメンターの皆様、ならびにEDGE POKER事業部の皆様に心より感謝申し上げます。
本当にありがとうございました!
参考文献
- Brown, N. & Sandholm, T. (2019). Superhuman AI for multiplayer poker . Science, 365(6456), 885–890.
- Johanson, M., Zinkevich, M. & Bowling, M. (2007). Computing Robust Counter-Strategies . Advances in Neural Information Processing Systems 20.
- Ganzfried, S. & Sandholm, T. (2015). Safe Opponent Exploitation . ACM Transactions on Economics and Computation, 3(2).
- Wu, Z. et al. (2021). L2E: Learning to Exploit Your Opponent . arXiv:2102.09381.
- Ganzfried, S. et al. (2022). Opponent Modeling in Multiplayer Imperfect-Information Games . arXiv:2212.06027.
- Peters, J., Mülling, K. & Altün, Y. (2010). Relative Entropy Policy Search . Proceedings of the AAAI Conference on Artificial Intelligence.
- Peng, X. B., Kumar, A., Zhang, G. & Levine, S. (2019). Advantage-Weighted Regression: Simple and Scalable Off-Policy Reinforcement Learning . arXiv:1910.00177.
- EDGE POKER 公式サイト .
- EDGE AIとは . 『EDGE POKER』公式 note.
- バディAIってほんとに似てるの? . 『EDGE POKER』公式 note.
- 【シーズン6振り返り】サメ診断のしくみと、EDGE POKERの運営について . 『EDGE POKER』公式note.

最後まで読んでいただき、ありがとうございます!
この記事をシェアしていただける方はこちらからお願いします。