


はじめに
こんにちは、IT 本部 IT 基盤部第一グループの横田です。 IT 基盤部では、組織横断的に複数のプロダクトのインフラ運用を行っており、インフラ基盤の安定稼働やコスト削減、開発体験の向上に取り組んでいます。
私たちがインフラ運用を担当するサービスでは、生成 AI を活用した機能を継続的に追加しています。 それらの機能では、 Amazon Bedrock や Gemini Enterprise Agent Platform 、 Microsoft Foundry など、用途に応じて複数のクラウドベンダーの推論 API を利用します。
一方で、新しい機能を追加するたびに、推論 API の認証や時間のかかる処理を非同期で実行する仕組み、監視などを個別に設計すると、生成 AI 機能そのものの開発よりも、インフラと運用の準備に時間がかかります。 また、機能ごとに異なる方法を採用すると、インフラ基盤を運用する側の認知負荷も高くなります。
そこで、 Amazon SQS (以下、SQS)と Amazon EKS (以下、EKS)を組み合わせ、生成 AI 機能に共通するインフラ設計と運用方法を整理し、再利用可能な非同期推論基盤を構築しました。 本記事では、この非同期推論基盤を新しい機能の開発時に選択できるゴールデンパスとして整備した背景と、マルチクラウド認証、非同期処理、開発チームとインフラチームの責任分界について紹介します。
生成 AI 機能を継続的に追加する上での課題
生成 AI を利用する機能では、採用するモデルやクラウドベンダーがユースケースによって異なります。 私たちは、複数のクラウドベンダーの推論 API をプロダクトに組み込む上で、主に次の課題があると考えました。
- クラウドベンダーごとに異なる認証情報と権限を安全に管理する必要がある
- 数秒から数分かかる推論処理を、本体システムのリクエスト処理から分離する必要がある
- 新機能のたびにキュー、ワーカー、再試行、監視を個別に設計すると開発に時間がかかる
- 実装方法が機能ごとに異なると、障害対応や利用状況、推論コストの把握が難しくなる
特に、認証情報やクラウドベンダーを切り替えるロジックを本体システムに集約すると、生成 AI 機能が増えるほど本体システムの責務も大きくなります。 反対に、機能ごとに認証や非同期処理の仕組みを一から作る方法では、同じ設計と実装を繰り返すことになります。
そこで、プラットフォームエンジニアリングの考え方を取り入れ、モデルごとの機能や公式 SDK はそのまま利用しながら、認証、ジョブキュー、デプロイ、オートスケール、監視といった共通部分をプラットフォームとして提供することにしました。
ゴールデンパスとして設計した非同期推論基盤
ゴールデンパスとは、開発チームが新しい機能を実装するときに利用できる、組織として推奨された開発・運用方法を指します。 強制的に全てのユースケースを一つの仕組みに合わせるのではなく、多くの機能で必要となる安全性や運用性を担保する仕組みを共通化し、標準的なケースを素早くリリースできる経路を提供します。
今回構築した非同期推論基盤では、生成 AI 機能ごとに SQS のキューと EKS 上のワーカーを用意します。 基本的な処理の流れは次のとおりです。
- サービス本体のシステムが、ジョブの識別子と推論に必要な情報を含むメッセージを SQS へ送信します。
- EKS 上のワーカーがメッセージを取得し、機能に応じた推論 API を公式 SDK から呼び出します。
- ワーカーが推論結果をサービス本体のシステムへコールバックします。
- コールバックまで正常に完了した後、ワーカーが SQS のメッセージを削除します。
SQS と EKS による非同期推論基盤の構成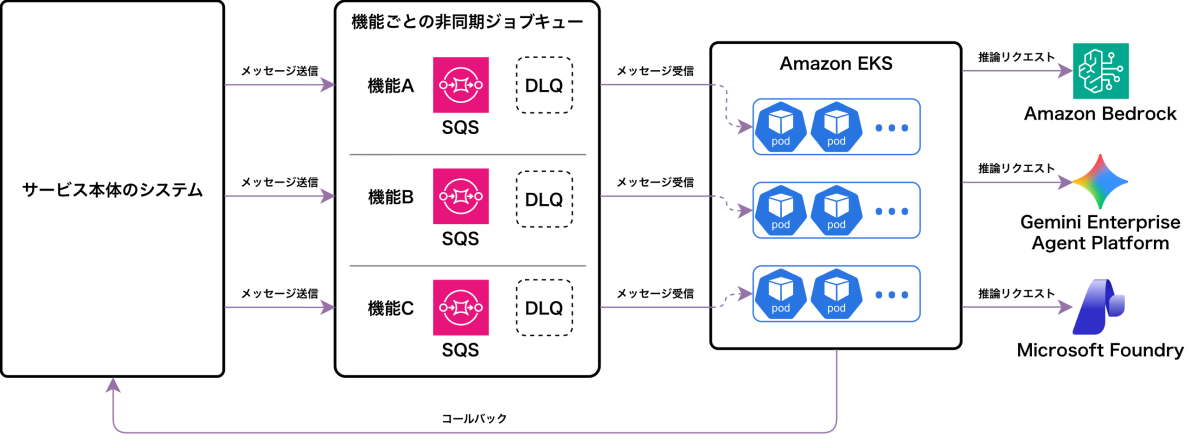
推論処理をワーカーへ分離することで、本体システムはクラウドベンダーごとの SDK や認証方法を意識せず、ジョブの登録と結果の受け取りに集中できます。 また、SQS が本体システムとワーカーの間のバッファとして働くため、一時的にジョブが増えた場合や推論 API の応答に時間がかかる場合でも、両者を独立してスケールできます。 例えば、定期実行バッチで大量の推論リクエストを処理する場合も、対応するキューへメッセージを投入することで、同じ仕組みを利用できます。 ワーカーのオートスケール設定を調整することで、推論 API のクォータの範囲内で、処理完了までの時間の目標に応じた処理能力を確保できます。
この構成を機能ごとに個別設計するのではなく、 Terraform モジュールと Helm チャートにまとめました。 Terraform モジュールはキュー、Dead Letter Queue(DLQ)、認証に必要なリソースと権限、監視設定を共通のルールで作成します。 Helm チャートはワーカーの Deployment、Kubernetes ServiceAccount、オートスケールなど、EKS 上で動作するリソースを共通化します。
プラットフォームが提供する範囲と、開発チームが担当する範囲は次のように分けています。
| 担当 | 主な責務 |
|---|---|
| インフラチーム | SQS、DLQ、OIDC 認証、EKS へのデプロイ、オートスケール、監視の共通設定 |
| 開発チーム | モデルの選定、プロンプト、推論処理、コールバック処理を実装したコンテナイメージ |
この責任分界により、インフラチーム側は安全性と運用性を共通の仕組みで担保し、開発チーム側はユーザーへ届ける価値に近い実装へ集中できます。
OIDC によるマルチクラウド認証の共通化
複数のクラウドを利用する際に、アクセスキーやサービスアカウントキーなどの長期間有効な認証情報をコンテナへ渡すと、保管、配布、更新、失効といった管理が必要になります。 そこで、Kubernetes API サーバーが発行する Kubernetes ServiceAccount のトークンと各クラウドの OpenID Connect(OIDC)連携を利用し、ワーカーが実行時に短期間有効な認証情報を取得する構成にしました。
Amazon Bedrock への認証
Amazon Bedrock のみを利用する場合、AWS が推奨する EKS Pod Identity を選択できます。 EKS Pod Identity は OIDC プロバイダーを必要とせず、EKS Auth API と各ノードで動作する Pod Identity Agent を通じて、一時的な AWS の認証情報をワーカーへ提供します。
一方、この非同期推論基盤では Google Cloud と Microsoft Azure の推論 API も利用するため、Kubernetes API サーバーが発行する Kubernetes ServiceAccount のトークンを使った OIDC 連携が必要です。 各クラウドベンダーの認証サービスは、EKS の OIDC Issuer エンドポイントで公開される公開鍵(JWKS)を使って、ServiceAccount トークンの署名を検証します。 EKS Pod Identity と各クラウドの OIDC 連携を併用することも技術的には可能ですが、異なる認証方式を管理することになります。 そこで、Kubernetes ServiceAccount と OIDC を中心とした共通設計で認証を管理するため、Amazon Bedrock を利用するワーカーには IAM Roles for Service Accounts(IRSA) を採用しました。
EKS クラスターの OIDC プロバイダーと Kubernetes ServiceAccount を IAM Role に関連付け、ワーカーは ServiceAccount のトークンを使って AssumeRoleWithWebIdentity を実行します。
コンテナに AWS のアクセスキーを保存する必要はなく、AWS SDK の標準的な認証情報取得の仕組みをそのまま利用できます。 本基盤では IAM Role を全ワーカーで共有し、機能ごとの SQS 権限は個別の IAM ポリシーとしてこのロールにアタッチしています。 Amazon Bedrock の権限は共有ポリシーで管理し、利用可能なモデルをポリシーで許可した範囲に制限しています。
Gemini Enterprise Agent Platform への認証
Google Cloud の Gemini Enterprise Agent Platform を利用するワーカーには、
Workload Identity Federation
を使用します。
Google Cloud 側の Workload Identity Pool に OIDC Provider を作成し、EKS の OIDC Issuer を Issuer URI として設定します。
また、トークンの sub クレームを google.subject にマッピングするとともに、assertion.sub.extract('system:serviceaccount:{ksa_name}') で抽出した値を attribute.ksa_name にマッピングします。
この属性で Kubernetes ServiceAccount を絞り込んだ Principal Set に、Google Cloud サービスアカウントの権限借用に必要な Workload Identity User(roles/iam.workloadIdentityUser)を付与します。
ワーカーは Kubernetes ServiceAccount のトークンを Google Cloud の Security Token Service でフェデレーショントークンに交換します。 続いて、そのトークンを使って Google Cloud サービスアカウントの権限を借用し、短期間有効なアクセストークンを取得します。 推論 API の利用に必要な権限は Google Cloud サービスアカウントへ付与します。 この認証フローは Google Cloud の認証構成ファイルと公式 SDK によって処理されるため、サービスアカウントキーを Kubernetes Secret として保存せずに Gemini Enterprise Agent Platform を利用できます。
Microsoft Foundry への認証
Microsoft Foundry を利用するワーカーにも、 Workload Identity Federation を使用します。 Microsoft Azure 側にユーザー割り当てマネージド ID を作成し、EKS クラスターごとの Federated Identity Credential をこの ID に関連付けます。
Federated Identity Credential には、EKS クラスターの OIDC Issuer URI、system:serviceaccount:<namespace>:<service-account> 形式の Subject、トークン交換用の Audience である api://AzureADTokenExchange を設定します。
Kubernetes API サーバーが発行した ServiceAccount トークンの Issuer、Subject、Audience が設定と一致すると、Microsoft Entra ID は、その ServiceAccount トークンを、ユーザー割り当てマネージド ID の短期間有効なアクセストークンに交換します。
ユーザー割り当てマネージド ID は生成 AI 機能で共有し、機能ごとに作成した AI Services アカウントのスコープで Cognitive Services OpenAI User ロールを付与します。 これにより、ワーカーはユーザー割り当てマネージド ID の権限で推論 API を呼び出せます。 クライアントシークレットをコンテナや Kubernetes Secret で管理する必要はありません。
各クラウドで設定するリソースは異なりますが、Kubernetes ServiceAccount をワークロードの ID とする考え方は共通しています。 認証に必要なリソースと Helm チャートの設定をインフラチーム側で管理することで、開発チームは認証情報の発行やローテーションを意識せず、公式 SDK を使って推論処理を実装できます。
SQS と EKS による非同期推論パイプライン
推論 API の応答時間は、利用するモデル、入出力サイズ、クラウドベンダー側の混雑状況などによって変化します。 本体システムのリクエスト処理の中で推論完了を待つと、タイムアウトしやすくなるだけでなく、推論 API の遅延や障害が本体システムへ波及します。
SQS を利用した非同期処理では、本体システムはメッセージの送信後に処理を終了し、推論結果をコールバックで受け取ります。 ワーカーが一時的に停止してもメッセージは SQS に保持されるため、復旧後に処理を再開できます。
可視性タイムアウトと再試行
ワーカーが SQS からメッセージを取得すると、そのメッセージは可視性タイムアウトの間、他のワーカーから取得できなくなります。 可視性タイムアウトが推論とコールバックに必要な時間より短いと、処理中のメッセージが再び取得され、同じジョブが並行して実行される可能性があります。 そのため、利用するモデルの応答時間とワーカー側のタイムアウトを考慮し、機能ごとに十分な可視性タイムアウトを設定する必要があります。
推論 API の一時的なエラーやコールバックの失敗が発生した場合は、ワーカーによる再試行や SQS のメッセージ再配信によって、処理を再実行します。 規定回数を超えても成功しないメッセージは DLQ へ移動し、通常のキューを滞留させずに原因を調査できるようにしています。 DLQ のメッセージ数やワーカーのエラーは共通の監視対象とし、機能ごとに同じ観点で異常を検知します。
SQS は少なくとも 1 回(At-Least-Once)の配信を前提とするため、同じメッセージが複数回処理される可能性があります。 そのため、同じメッセージが複数回処理され、コールバックが重複した場合でも、サービス本体のシステム側で冪等性が保たれるように実装しています。
KEDA によるオートスケール
ワーカーの Pod 数調整には KEDA を使用しています。 KEDA の Amazon SQS Queue Scaler がキューのメッセージ数を監視し、処理待ちのジョブ数に応じてワーカーの Pod 数を増減させます。
メッセージがないときは Pod 数を 0 にすることで、生成 AI 機能が利用されていない時間のコンピューティングコストを抑えられます。 一方で、0 Pod から起動するときには Pod のスケジューリングやイメージ取得に時間がかかるため、即時性が特に重要な機能では最小 Pod 数を 1 以上に設定し、ワーカーを常時起動します。
キューの長さだけを見て無制限に Pod を増やすと、推論 API のクォータや Rate Limit を超える可能性があります。 そのため、機能ごとに処理時間とクラウドベンダー側の上限を確認し、最大 Pod 数や一つの Pod が同時に処理するジョブ数を設定しています。
ApproximateAgeOfOldestMessage によるキュー遅延の監視
SQS キューに投入された推論リクエストの遅延を管理するため、Amazon CloudWatch の ApproximateAgeOfOldestMessage を監視しています。
このメトリクスは、SQS キューに残っている最古の未処理メッセージの経過時間を秒単位で示します。
値が大きくなった場合、ワーカーの処理能力がリクエスト数に追いついていないことや、推論 API の遅延などが原因で、キューにメッセージが滞留している可能性があります。 機能ごとに想定する処理時間をもとに閾値を設定し、一定時間を超えた場合に検知することで、推論結果を返すまでの遅延が拡大する兆候を把握しています。
標準キューでは、3 回以上受信されても削除されないメッセージはキューの末尾へ移動し、このメトリクスの集計対象から外れる場合があります。 そのため、失敗が続くメッセージは DLQ のメッセージ数とワーカーのエラーログで検知しています。
この非同期推論基盤ではコールバックが正常に完了した後に SQS のメッセージを削除しますが、ApproximateAgeOfOldestMessage は受信後に処理中となった個々のメッセージの所要時間を直接示すものではありません。
そのため、推論リクエストごとの応答時間ではなく、キューの滞留と処理遅延の兆候を検知する運用指標として利用しています。
一方で、モデル評価やプロンプト調整に利用する推論時間のメトリクスは、別途 LLMOps ツールで収集・可視化しています。
新しい生成 AI 機能を追加する開発フロー
新しい生成 AI 機能を追加する際、開発チームが用意する中心的な成果物はワーカーのコンテナイメージです。 ワーカーは SQS からメッセージを受け取り、選択したクラウドベンダーの公式 SDK でモデルを呼び出し、結果を本体システムへコールバックします。 開発チームはワーカーのリポジトリの CI/CD でコンテナイメージをビルドし、 Amazon Elastic Container Registry (以下、ECR)へプッシュします。
コンテナイメージの自動デプロイには、Argo CD Image Updater によるイメージ情報の Git リポジトリへの自動書き込みを利用しています。 詳細は以下の記事で紹介しています。
インフラチームは、共通の Terraform モジュールと Helm チャートに機能名、利用するクラウド、タイムアウト、オートスケールなどの設定を渡して、必要なリソースを展開します。 認証、再試行、DLQ、監視などの基本方針はテンプレートに組み込まれているため、機能ごとに設計し直す必要はありません。
機能追加の流れをまとめると、次のようになります。
- 機能の要件に合わせてクラウドベンダーとモデルを選定し、プロンプトを決定します。
- 公式 SDK を用いた推論 API の呼び出し、ガードレール、機能固有の処理、コールバックを実装したワーカーをコンテナ化します。
- ワーカーのリポジトリの CI/CD でコンテナイメージをビルドし、ECR へプッシュします。
- Terraform モジュールと Helm チャートの共通設定からキュー、認証、ワーカー、オートスケール、監視を展開します。
- 本体システムからキューへジョブを送信し、コールバックまでの動作を確認してリリースします。
このように、開発チームはワーカーの実装からコンテナイメージのビルドと ECR へのプッシュまで、インフラチームはプッシュされたイメージの自動デプロイと実行環境の運用を担当することで、両チームの責任範囲を明確に分けることができます。 これにより、開発チームはクラウドごとの認証情報の管理や Kubernetes リソースの詳細を意識せず、モデルの選定やプロンプトエンジニアリングなど、ユーザー体験の向上に集中できます。 ゴールデンパスに沿わない特殊な要件がある場合は個別の構成を選択できますが、標準的な非同期推論であれば実績のある構成をそのまま再利用できます。
導入によって得られた効果
この非同期推論基盤の導入後は、生成 AI 機能を追加するたびに認証方法や非同期実行の仕組みを検討する必要がなくなりました。 開発チームはプラットフォームが提供する仕組みで動作するワーカーを用意すればよく、モデルの選定やプロンプトエンジニアリングなど、ユーザー体験の向上に集中できるようになりました。 また、複数のクラウドベンダーの推論 API を利用できるため、推論処理に失敗した場合には別のクラウドベンダーへフォールバックして処理を継続できます。
インフラチームにとっても、機能ごとに異なる構成を理解して運用するのではなく、Terraform モジュールと Helm チャートで共通化されたリソースを同じ観点で管理できます。 ログ、メトリクス、アラートを共通のルールで設定することで、キューの滞留、ワーカーのエラー、DLQ への移動といった状態を横断的に確認できるようになりました。
コスト面では、EKS の Node として利用している EC2 インスタンスに Spot インスタンスを利用できています。 ap-northeast-1 の c8g.large(Linux)の執筆時点の価格を基準にすると、Spot インスタンスの利用により、On-Demand インスタンスと比べて EC2 の時間単価を約 50% 削減できます。1 SQS にメッセージが保持されるため、EC2 インスタンスの中断後も処理を再実行できます。 さらに、処理待ちのジョブがない時間帯は KEDA でワーカーの Pod 数を 0 にし、 Karpenter による Node のオートスケールと組み合わせてワーカー用の Node も 0 台にすることで、未使用時のコンピューティングコストを抑えています。
また、機能とクラウド上のリソースとの対応関係が明確になり、どの機能がどの推論 API を利用しているかを追跡しやすくなりました。 利用状況と推論コストも機能やクラウドベンダーの単位で整理できるため、運用状況の把握とコスト管理を一元的に進められます。
効果を単純な開発工数として比較することは難しいものの、新機能を追加するときの検討事項と実装範囲を減らし、開発チームとインフラチームの責任分界点を明確にできたことが成果だと考えています。
設計上のトレードオフ
ゴールデンパスとして共通化する範囲を広げすぎると、モデルごとの新機能を活用しにくくなります。 そのため、推論 API 自体を独自の共通 API で抽象化せず、各クラウドベンダーの公式 SDK をワーカーから直接利用する設計にしています。 認証と実行環境は共通化しながら、モデル固有のパラメーターやレスポンス形式は開発チーム側で扱うという境界になっています。
また、非同期処理を採用することで、メッセージの重複やコールバック先の一時的な障害を前提に、可視性タイムアウト、再試行、冪等性、DLQ を設計する必要があります。 KEDA によるオートスケールも、EKS 側の処理能力だけでなく、推論 API のクォータや Rate Limit と合わせて設計する必要があります。 今後も、新しいクラウドベンダーや運用上の知見を共通モジュールへ反映し、各機能で個別に対応しなくても改善を取り込める状態を維持して運用していくことを考えています。
おわりに
本記事では、私たちがインフラ運用を担当するサービスにおいて、生成 AI 機能を継続的に追加するために構築した、SQS と EKS による非同期推論基盤を紹介しました。 OIDC を利用したマルチクラウド認証と、Terraform モジュール、Helm チャート、KEDA による実行環境をプラットフォームとして提供し、その利用方法をゴールデンパスとして整備することで、開発チームが機能固有の実装に集中できるようになりました。
今回のポイントは、全ての推論 API を一つに抽象化することではなく、認証、非同期実行、デプロイ、オートスケール、監視といった共通部分を、再利用可能な標準構成として提供したことです。 この設計により、モデルやクラウドベンダーを機能ごとに選択できる柔軟性を維持しながら、安全性と運用性を備えた生成 AI 機能を素早くリリースできるようになります。
生成 AI 機能の開発体験向上や運用改善に取り組む方にとって、本記事が参考になれば幸いです。
-
2026 年 9 月 9 日時点の AWS 公式料金ページを参照しました。 On-Demand 料金 の 0.1001 USD/時と、 Spot 料金 のリージョン内最低価格 0.0487 USD/時から、削減率を約 51.3% と算出しています。Spot 価格は Availability Zone や需要によって変動するため、実際の削減率は一定ではありません。 ↩︎


最後まで読んでいただき、ありがとうございます!
この記事をシェアしていただける方はこちらからお願いします。